视频加载失败

Lec3: Bellman Optimality Equation

Bellman 最优方程及其压缩映射性质,Banach 不动点定理保证收敛唯一解,以及最优策略的存在性。

课程导航与课程讲次
课程讲次
文章目录

Motivating examples#

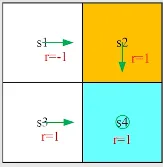
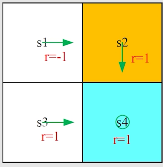
​ 我们以一个例子作为引入:

image-20260201194959813

​ 于是显然有:

vπ(s1)=−1+γvπ(s2),vπ(s2)=+1+γvπ(s4),vπ(s3)=+1+γvπ(s4),vπ(s4)=+1+γvπ(s4).\begin{aligned} v_{\pi}(s_1) &= -1 + \gamma v_{\pi}(s_2), \\ v_{\pi}(s_2) &= +1 + \gamma v_{\pi}(s_4), \\ v_{\pi}(s_3) &= +1 + \gamma v_{\pi}(s_4), \\ v_{\pi}(s_4) &= +1 + \gamma v_{\pi}(s_4). \end{aligned}

​ 假设 γ=0.9\gamma = 0.9,计算得到:

vπ(s4)=vπ(s3)=vπ(s2)=10,  vπ(s1)=8v_{\pi}(s_4)=v_{\pi}(s_3)=v_{\pi}(s_2)=10, \; v_{\pi}(s_1)=8

​ 于是我们就可以计算得到每一个状态的所有的 Action value:

qπ(s1,a1)=−1+γvπ(s1)=6.2,qπ(s1,a2)=−1+γvπ(s2)=8,qπ(s1,a3)=0+γvπ(s3)=9,qπ(s1,a4)=−1+γvπ(s1)=6.2,qπ(s1,a5)=0+γvπ(s1)=7.2.\begin{align} q_{\pi}(s_1, a_1) &= -1 + \gamma v_{\pi}(s_1) = 6.2, \\ q_{\pi}(s_1, a_2) &= -1 + \gamma v_{\pi}(s_2) = 8, \\ q_{\pi}(s_1, \color{blue}{a_3}) &= 0 + \gamma v_{\pi}(s_3) = 9, \\ q_{\pi}(s_1, a_4) &= -1 + \gamma v_{\pi}(s_1) = 6.2, \\ q_{\pi}(s_1, a_5) &= 0 + \gamma v_{\pi}(s_1) = 7.2. \end{align}

​ 对于原来的策略,我们可以写成:

π(a∣s1)={1a=a20a≠a2\pi(a|s_1) = \begin{cases} 1 & a = a_2 \\ 0 & a \neq a_2 \end{cases}

​ 我们可以发现,原来的策略并不是最好的,因为它走进了 forbidden area。于是,我们可以把策略换成 action value 最大的那一条路:

πnew(a∣s1)={1a=a∗0a≠a∗a∗=arg⁡max⁡aqπ(s1,a)=a3.\pi_{\text{new}}(a|s_1) = \begin{cases} 1 & a = a^* \\ 0 & a \neq a^* \end{cases} \\ a^* = \arg\max_{a} q_{\pi}(s_1, a) = a_3.

​ 直观上来来理解,选择一个 action value 最大 action 就可以获得一个最好的策略。

​ 但在数学上,有时候仅仅一次的选择不能保证整个 π\pi 的选择都是最优的。(我们需要从终点向起点开始,一步步保证最优)于是可以选择多迭代几轮来达到整体的最优。

Optimal policy#

​ 我们定义策略 π1\pi_{1} 比 π2\pi_{2} 更优(better)如果:

vπ1(s)≥vπ2(s)for  all  s∈Sv_{\pi_1}(s) \geq v_{\pi_2}(s) \quad for\;all \; s\in \mathcal{S}

​ 同时定义策略 π∗\pi^* 是最优(optimal)的若:

vπ∗(s)≥vπ(s)for  all  s  and  other  policy  πv_{\pi^*}(s) \geq v_{\pi}(s) \quad for \; all \; s \; and\;other\;policy\; \pi

Bellman optimality equation(BOE)#

v(s)=max⁡π∑aπ(a∣s)(∑rp(r∣s,a)r+γ∑s′p(s′∣s,a)v(s′)),∀s∈S=max⁡π∑aπ(a∣s)q(s,a)s∈S\begin{align} v(s) &= {\max_{\pi}} \sum_{a} {\pi(a|s)} \left( \sum_{r} p(r|s, a)r + \gamma \sum_{s'} p(s'|s, a)v(s') \right), \quad \forall s \in \mathcal{S} \\ &= {\max_{\pi}} \sum_{a} {\pi(a|s)} q(s, a) \quad s \in \mathcal{S} \end{align}

​ 以上就是 BOE。我们的目标是求出一个最优的策略 π\pi,使得 v(s)v(s) 的值最大。

​ 类似的我们可以将贝尔曼最优公式写成向量形式:

v=max⁡π(rπ+γPπv)[rπ]s≜∑aπ(a∣s)∑rp(r∣s,a)r[Pπ]s,s′=p(s′∣s)≜∑aπ(a∣s)∑s′p(s′∣s,a)\mathbf{v} = \max_{\pi} (\mathbf{r}_{\pi} + \gamma \mathbf{P}_{\pi} \mathbf{v}) \\ [\mathbf{r}_{\pi}]_s \triangleq \sum_{a} \pi(a|s) \sum_{r} p(r|s, a)r \\ [\mathbf{P}_{\pi}]_{s,s'} = p(s'|s) \triangleq \sum_{a} \pi(a|s) \sum_{s'}p(s'|s, a)

​ 这里第二三行的下标指的是向量中的一项。比如 [Pπ]s,s′[\mathbf{P}_{\pi}]_{s,s'},指的是 [Pπ][\mathbf{P}_{\pi}] 中的第 ss 行,第 s′s' 列。

Maximization on the right-hand side of BOE#

​ 我们先来处理贝尔曼最优公式的右边的最大(max)部分。

​ 回顾最优策略的定义,我们知道其要对任意状态 ss 都要成立,因此我们先考虑一个特殊的状态 ss:

v(s)=max⁡π∑aπ(a∣s)(∑rp(r∣s,a)r+γ∑s′p(s′∣s,a)v(s′)),∀s∈S=max⁡π∑aπ(a∣s)q(s,a)s∈S\begin{align} v(s) &= {\max_{\pi}} \sum_{a} {\pi(a|s)} \left( \sum_{r} p(r|s, a)r + \gamma \sum_{s'} p(s'|s, a)v(s') \right), \quad \forall s \in \mathcal{S} \\ &= {\max_{\pi}} \sum_{a} {\pi(a|s)} q(s, a) \quad s \in \mathcal{S} \end{align}

​ 我们知道,∑aπ(a∣s)=1\sum_{a}\pi(a \mid s)=1,且对于一个场景来说,q(s,a)q(s,a)是确定的。因此有:

max⁡π∑aπ(a∣s)q(s,a)≤∑aπ(a∣s)⋅max⁡a∈Aq(s,a)=max⁡a∈Aq(s,a){\max_{\pi}} \sum_{a} {\pi(a|s)} q(s, a) \leq \sum_a \pi(a \mid s) \cdot \max_{a \in \mathcal{A}}q(s,a)=\max_{a \in \mathcal{A}}q(s,a)

​ 当且仅当:

π(a∣s)={ 1a=a∗ 0a≠a∗a∗=arg⁡max⁡aq(s,a)\pi(a|s) = \begin{cases}   1 & a = a^* \\   0 & a \neq a^* \end{cases} \\ a^*=\arg \max_aq(s,a)
Note

对于这里的推导,一种可能的解释是,q(s,a)q(s,a) 确实依赖于我们之前所算出来的策略 π\pi,但是,在优化的过程中,我们始终将此次的 q(s,a)q(s,a) 看作是一个定值进行计算。经过多次迭代后,一定会得到最优解。

The whole of BOE#

v=max⁡π(rπ+γPπv)v=\max_{\pi}(r_\pi + \gamma P_\pi v)

​ 经过上面的分析,我们知道 π\pi 和 vv 之间有密不可分的联系。不妨将 π\pi 视作 vv 的一个函数,我们就能得到:

f(v):=max⁡π(rπ+γPπv)f(v):=\max_\pi (r_\pi+\gamma P_\pi v)

​ 于是就有:

v=f(v)where[f(v)]s=max⁡π∑aπ(a∣s)q(s,a),s∈Sv=f(v)\\ where\\ [f(v)]_s=\max_{\pi}\sum_a \pi(a \mid s)q(s,a), \quad s \in \mathcal{S}

​ 显然,这是一个有关不动点的问题。

Fixed point & Contraction mapping#

​ 在继续正文部分之前,我们首先来介绍一下不动点(Fixed point)以及 Contraction mapping theorem。

​ 我们称一个点 x∈Xx \in X 为函数 f:X→Xf:X \rightarrow X 的 Fixed point 若:

f(x)=xf(x)=x

​ 我们称 ff 为一个 contraction mapping 若:

∣∣f(x1)−f(x2)∣∣≤γ∣∣x1−x2∣∣γ∈(0,1)||f(x_1)-f(x_2)|| \leq \gamma||x_1-x_2|| \\ \gamma \in \left( 0,1 \right)

​ 此处的两个 ∣∣|| 操作,一个用于取绝对值,一个用于计算矩阵的值。

Contraction mapping theorem#

​ 对任何形如 x=f(x)x=f(x) 的等式来说,若 ff 为 contraction mapping,则:

  • 必定存在一个不动点 x∗x^*,满足 f(x∗)=x∗f(x^*)=x^*
  • 这个不动点 x∗x^* 是唯一的
  • 考虑一组序列 {xk}\{x_k\},满足 xk+1=f(xk)x_{k+1}=f(x_k)。当 k→∞k \rightarrow \infin 的时候,xk→x∗x_k \rightarrow x^*。而且,增长率是指数级别增加的(非常快)

​ 回到正文,对于贝尔曼最优方程 v=f(v)=max⁡π(rπ+γPπv)v=f(v)=\max_{\pi}(r_\pi + \gamma P_\pi v) 来说,有:

∣∣f(v1)−f(v2)∣∣≤γ∣∣v1−v2∣∣||f(v_1)-f(v_2)|| \leq \gamma||v_1-v_2||

​ 所以,f(v)=vf(v)=v 是 contraction mapping 的。因此由 BOE 的三条性质,我们知道:

  • 对于 BOE v=f(v)=max⁡π(rπ+γPπv)v=f(v)=\max_{\pi}(r_\pi + \gamma P_\pi v) 来说,一定存在一个唯一的答案,而且这个答案可以被递归的计算出来:
vk+1=f(vk)=max⁡π(rπ+γPπvk)v_{k+1}=f(v_k)=\max_\pi (r_\pi+\gamma P_\pi v_k)

​ 这个式子的收敛程度是指数级快的,且收敛等级是由 γ\gamma 所决定的。

Policy optimality#

​ 假设 v∗v^* 是贝尔曼最优方程的解,那么就会满足下面的式子:

v∗=max⁡π(rπ+γPπv∗)v^*=\max_\pi(r_\pi+\gamma P_\pi v^*)

​ 假设:

π∗=arg⁡max⁡π(rπ+γPπv∗)\pi^*=\arg \max_\pi(r_\pi+\gamma P_\pi v^*)

​ 于是就有:

v∗=rπ∗+γPπ∗v∗v^*=r_{\pi^*}+\gamma P_{\pi^*} v^*

​ 其中,π∗{\pi}^* 是最优策略且 v∗=vπ∗v^*=v_{\pi^*} 是对应的 state value。

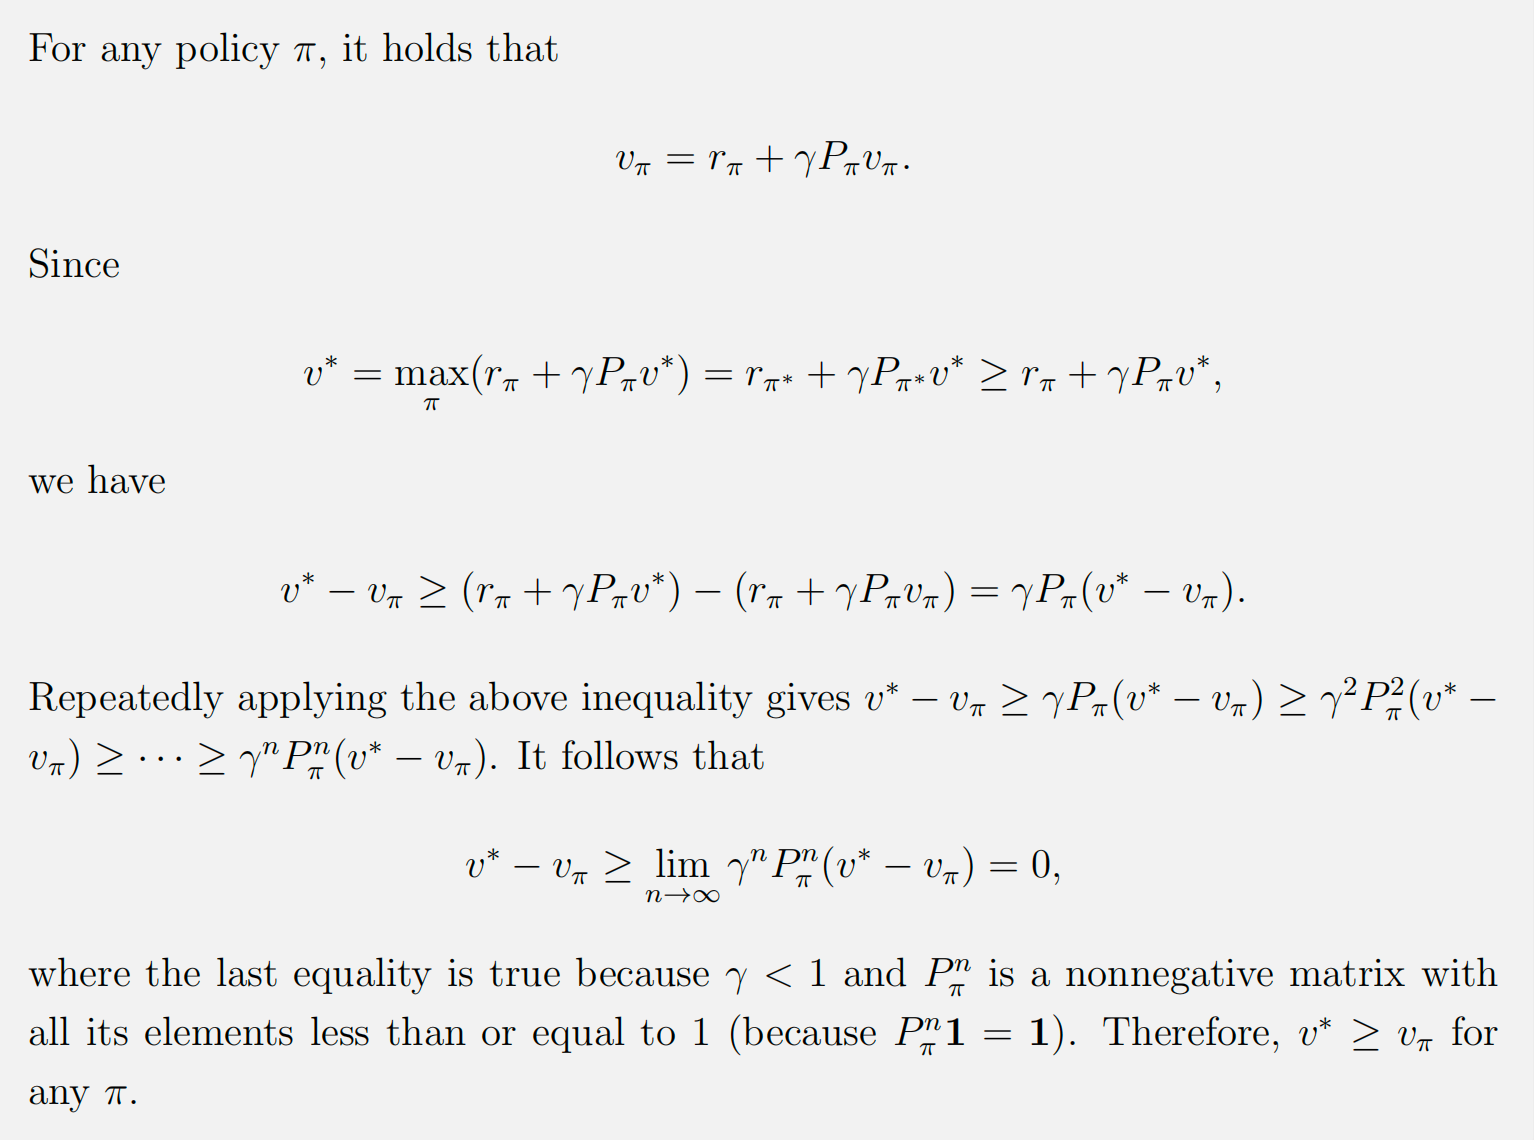
Provement#

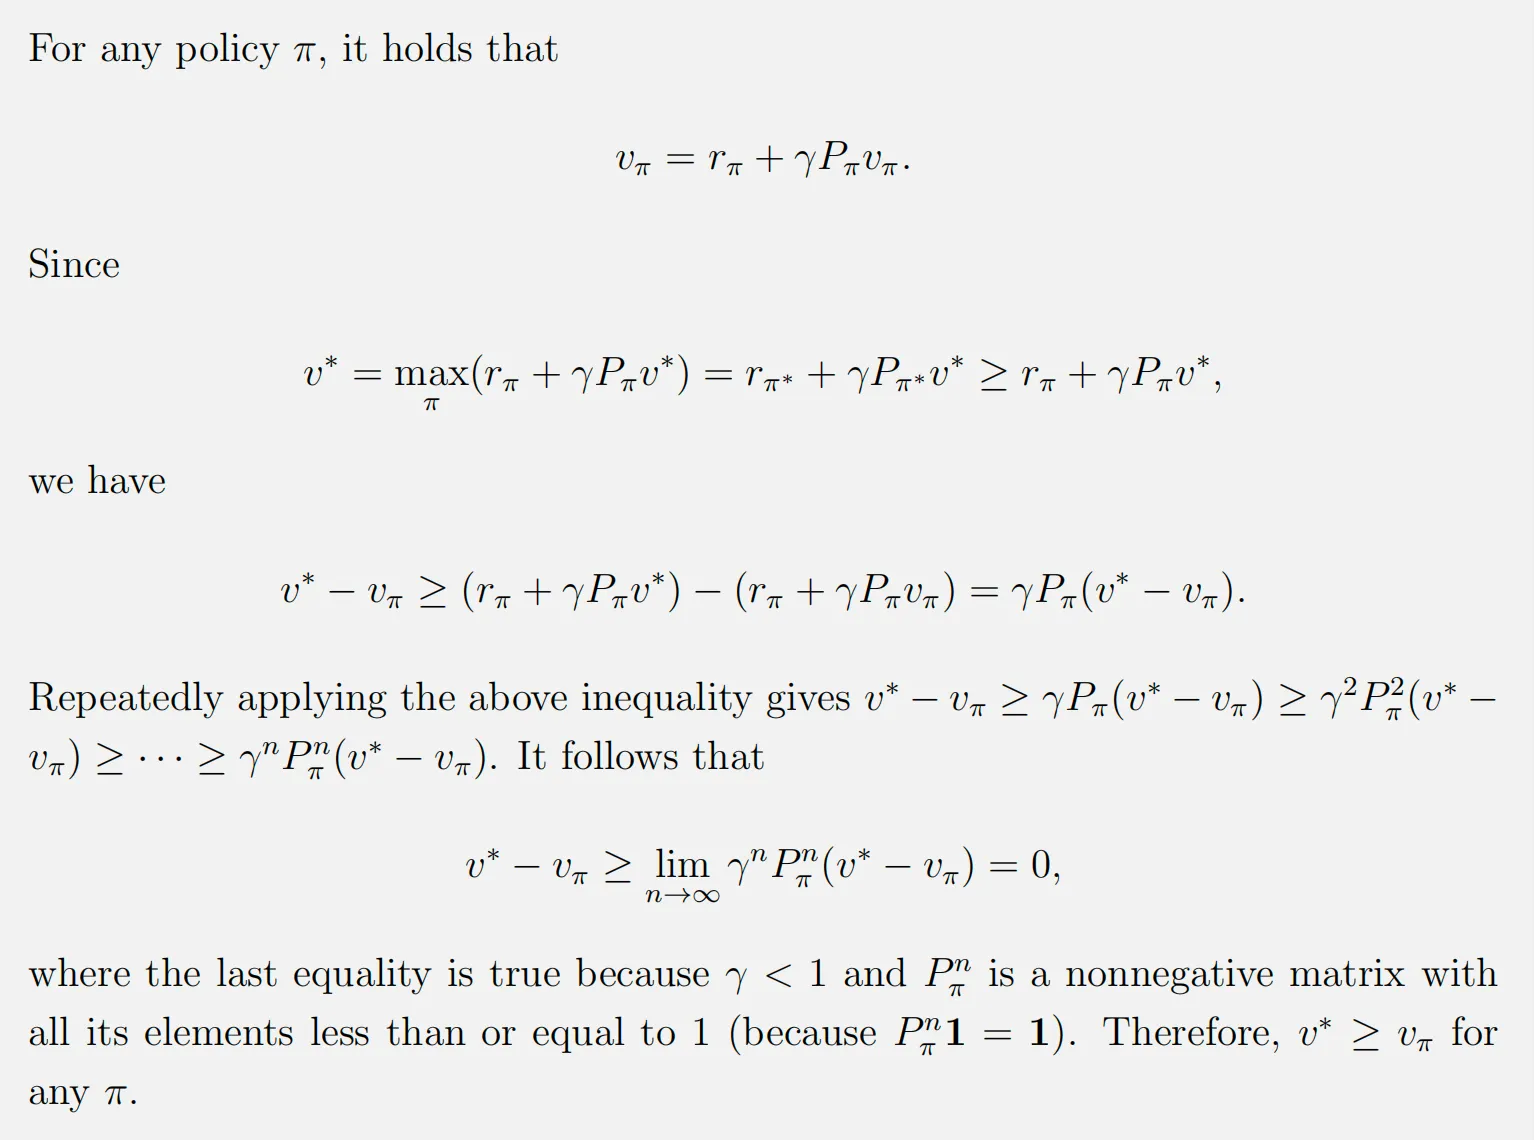
​ 至于为什么 v∗v^* 和 π∗\pi^* 是最优的,我们可以参考以下证明过程:

image-20260202143635986

Optimal policy#

​ 由上面的推导中,我们可以总结出一个 theorem(Greedy Optimal Policy):

对任意 s∈Ss \in \mathcal{S},the deterministic greedy policy:

π∗(a∣s)={1a=a∗(s)0a≠a∗(s)\pi^*(a|s) = \begin{cases} 1 & a = a^*(s) \\ 0 & a \neq a^*(s) \end{cases}

是一个可以解决 BOE 的 optimal policy。此时:

a∗(s)=arg⁡max⁡aq∗(a,s)a^*(s)=\arg \max_aq^*(a,s)

且:

π∗(s)=arg⁡max⁡π∑aπ(a∣s)(∑rp(r∣s,a)r+γ∑s′p(s′∣s,a)v∗(s′))⏟q∗(s,a)\pi^*(s)=\arg \max_\pi \sum_a \pi(a \mid s)\underbrace{\left(\sum_rp(r \mid s,a)r+\gamma \sum_{s'}p(s' \mid s,a)v^*(s')\right)}_{q^*(s,a)}

Analyzing optimal policies#

​ 我们接下来分析影响最优策略的因素:

v(s)=max⁡π∑aπ(a∣s)(∑rp(r∣s,a)r+γ∑s′p(s′∣s,a)v(s′))v(s) = \max_{\pi} \sum_{a} \pi(a|s) \left( \sum_{r} \textcolor{red}{p(r|s, a)r} + \textcolor{red}{\gamma} \sum_{s'} \textcolor{red}{p(s'|s, a)}v(s') \right)

​ 观察公式,我们可以发现正是红色部分的内容影响了最优策略:

  • Reward design:rr
  • System model:p(s′∣s,a),  p(r∣s,a)p(s' \mid s,a), \; p(r\mid s,a)
  • Discount rate:γ\gamma

​ 对于 discount rate γ\gamma 来说,越高代表越远视,越低代表越近视。

rr 的改变#

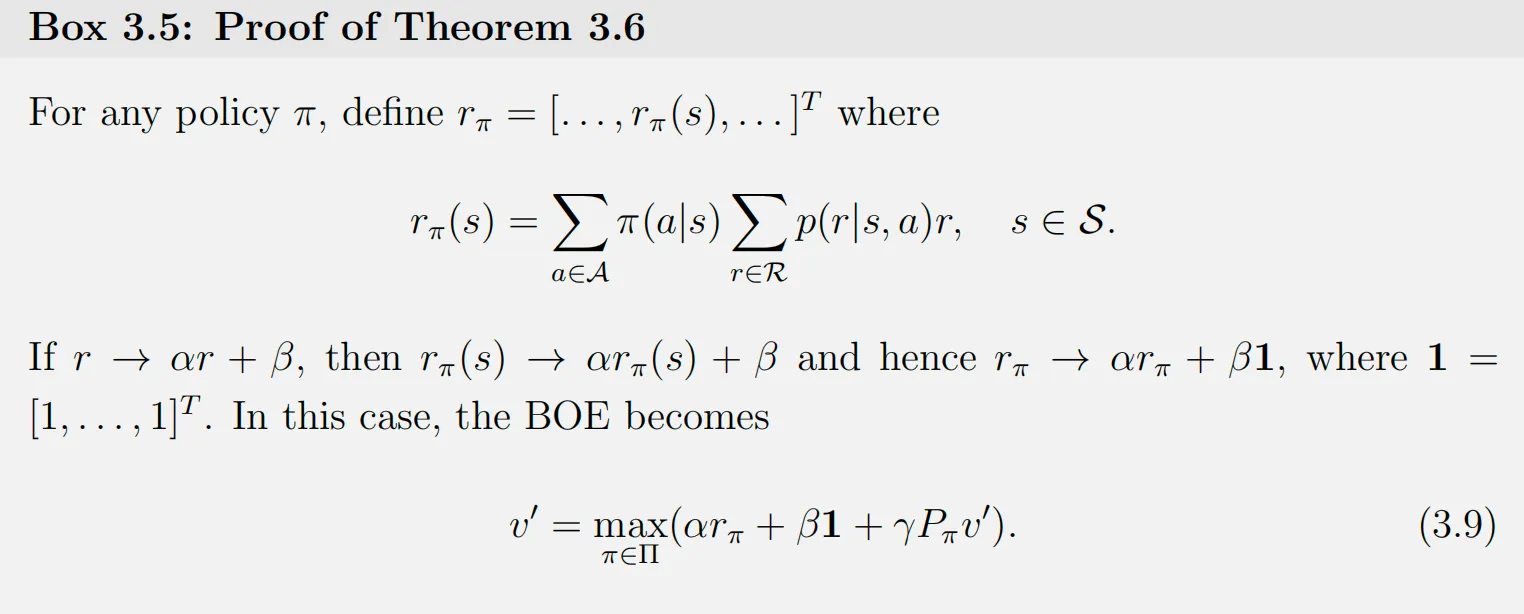
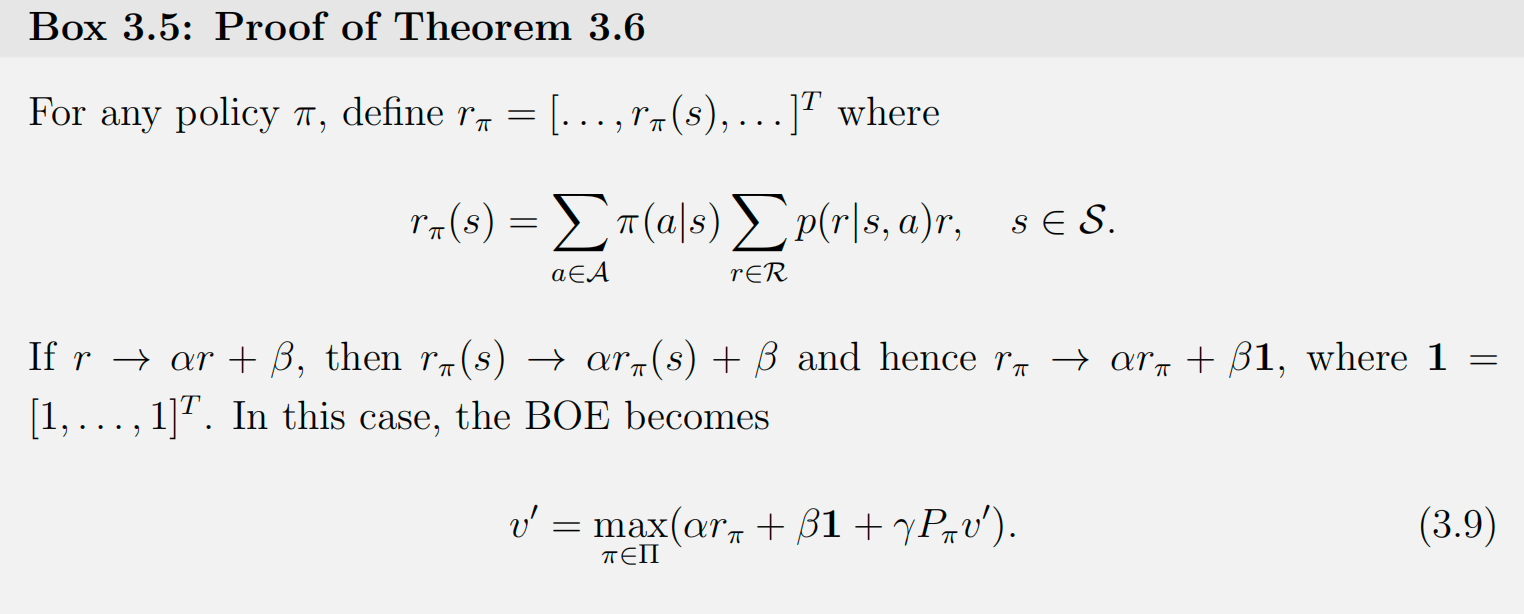
​ 接下了我们来看一种特殊的情况,我们改变奖励 r→αr+βr \rightarrow \alpha r+\beta。

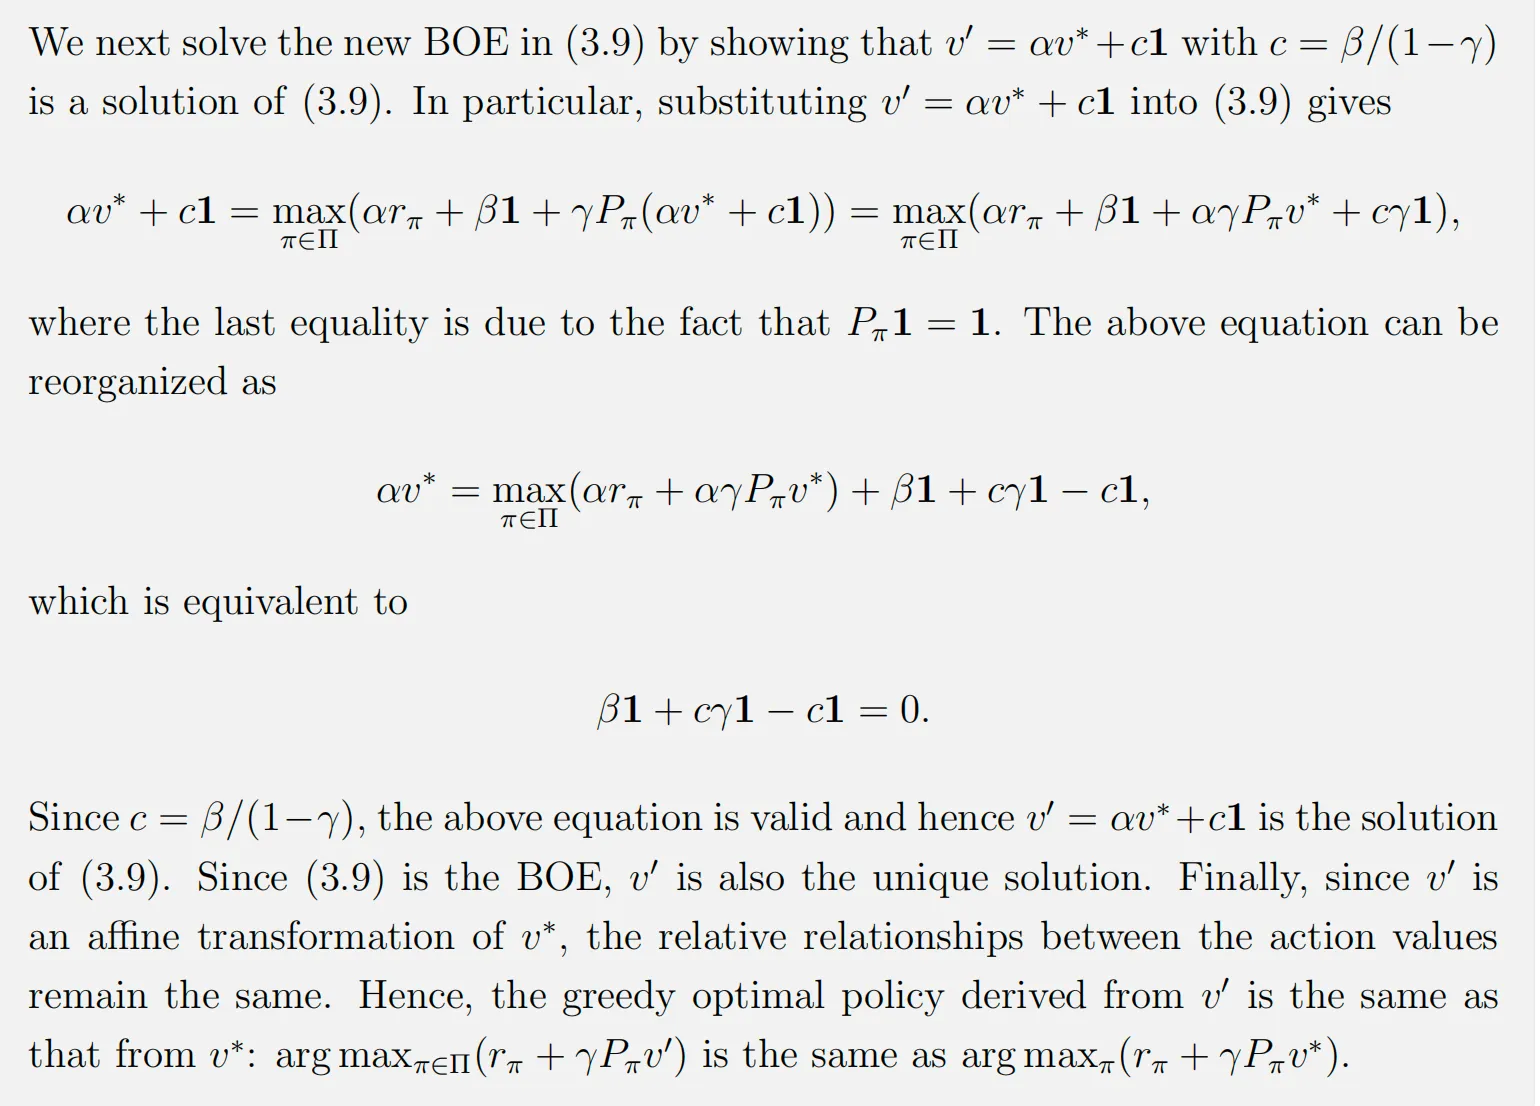
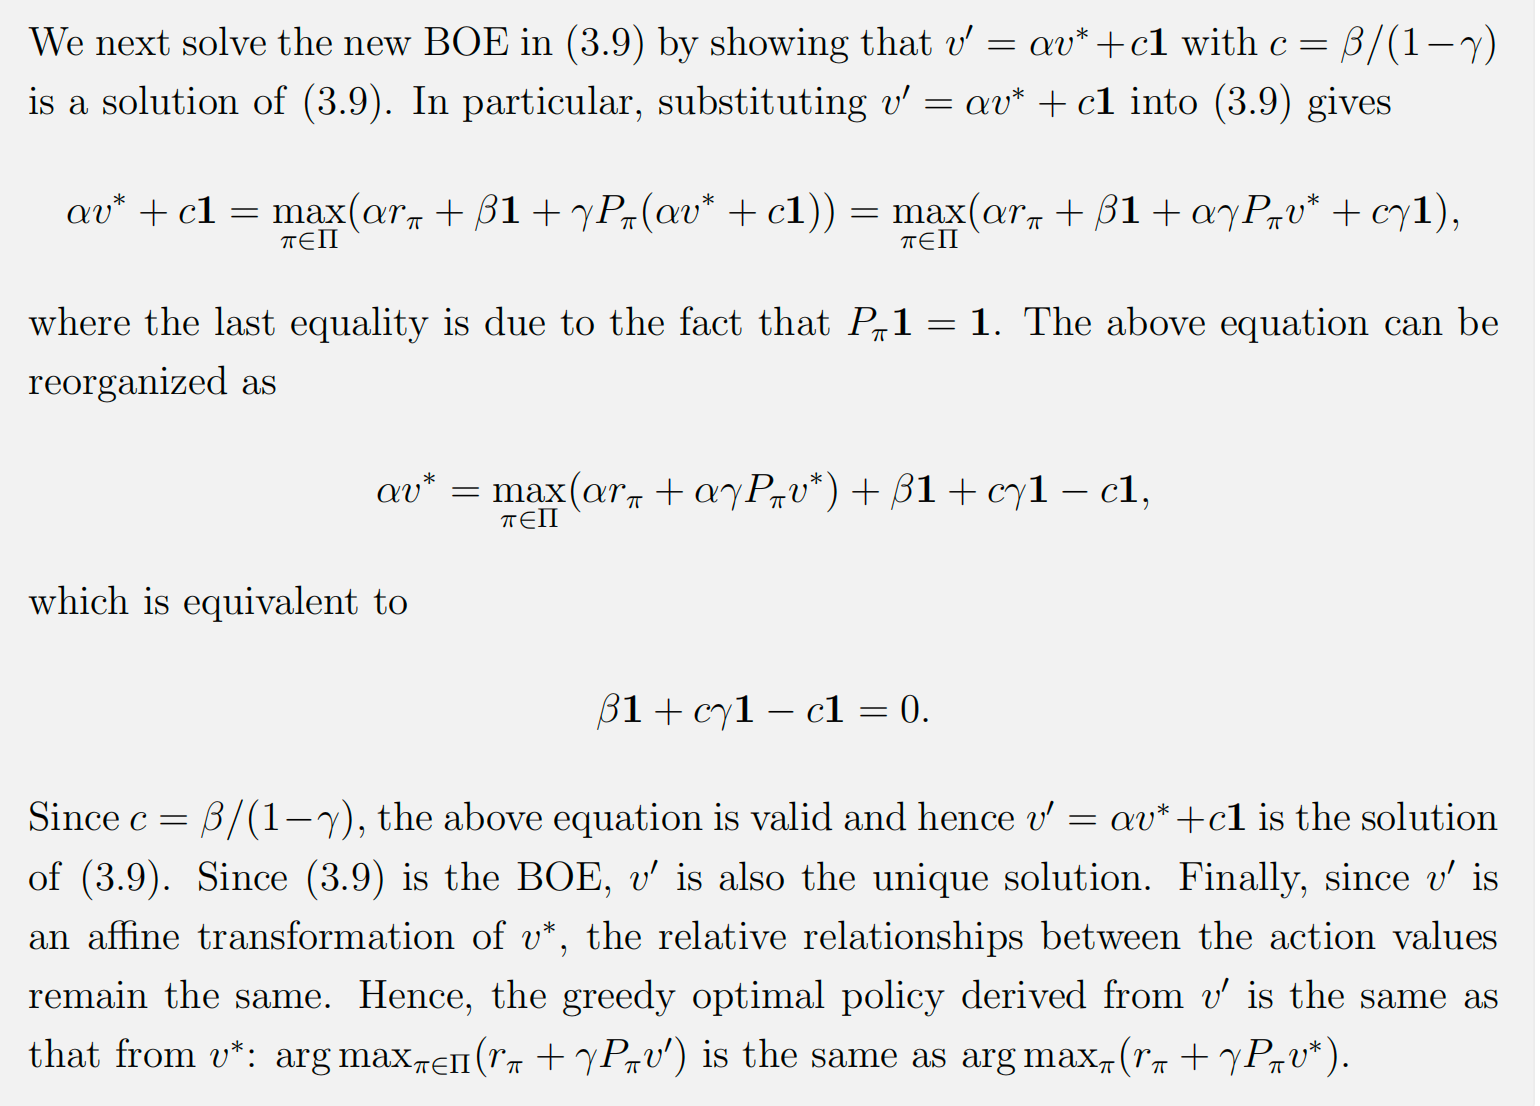
​ 可以证明的是,改变后的最优策略以及 state value 相对大小关系并未改变。

v′=αv∗+β1−γ1v'=\alpha v^*+\frac{\beta}{1-\gamma}\mathbf{1}

​ 具体证明如下所示:

image-20260202161917954
image-20260202161927617

文章目录