


Lec10: 视频理解
视频片段采样、时序建模、3D CNN、光流双流网络与视频 Transformer。
课程导航与课程讲次
课程讲次
文章目录
视频与训练 clip
视频张量常写为 。原视频巨大,训练通常随机采样低帧率、低分辨率短 clip;测试时采样多个 clip,平均预测。
图像主要识别物体,视频还要识别动作、时间顺序和交互。场景、物体等静态线索很强,因此单帧 CNN + 概率平均是必须比较的基线。
时序模型
2D CNN Late Fusion
各帧经共享 CNN 后融合:
- 拼接特征 + MLP:保留顺序,但固定长度。
- 时空平均池化 + 线性层:可变长度,但丢失顺序和局部运动。
适合高层场景分类,不擅长低层运动比较。
3D CNN 与 I3D
3D 卷积核为 ,在时空体上滑动,逐层融合时间信息。I3D 将 2D 卷积核沿时间复制 次并除以 ,静态视频上与原 2D 卷积输出一致,因此可复用 ImageNet 预训练。
光流双流网络
光流描述相邻帧像素位移:
外观流处理 RGB,运动流处理光流,后融合。现代模型通常直接从 RGB 学运动,光流主要用于对应与控制等显式运动任务。
视频 Transformer
每帧 224×224 图像以 16×16 patch 切分有 196 token;16 帧即 3136 token。直接联合时空 attention 的复杂度为 。
两条效率路线:
- 修改 attention。
- 分解时空 attention:同一空间位置跨帧做时间注意力,同一帧内做空间注意力;每 token 成本从 降为 。
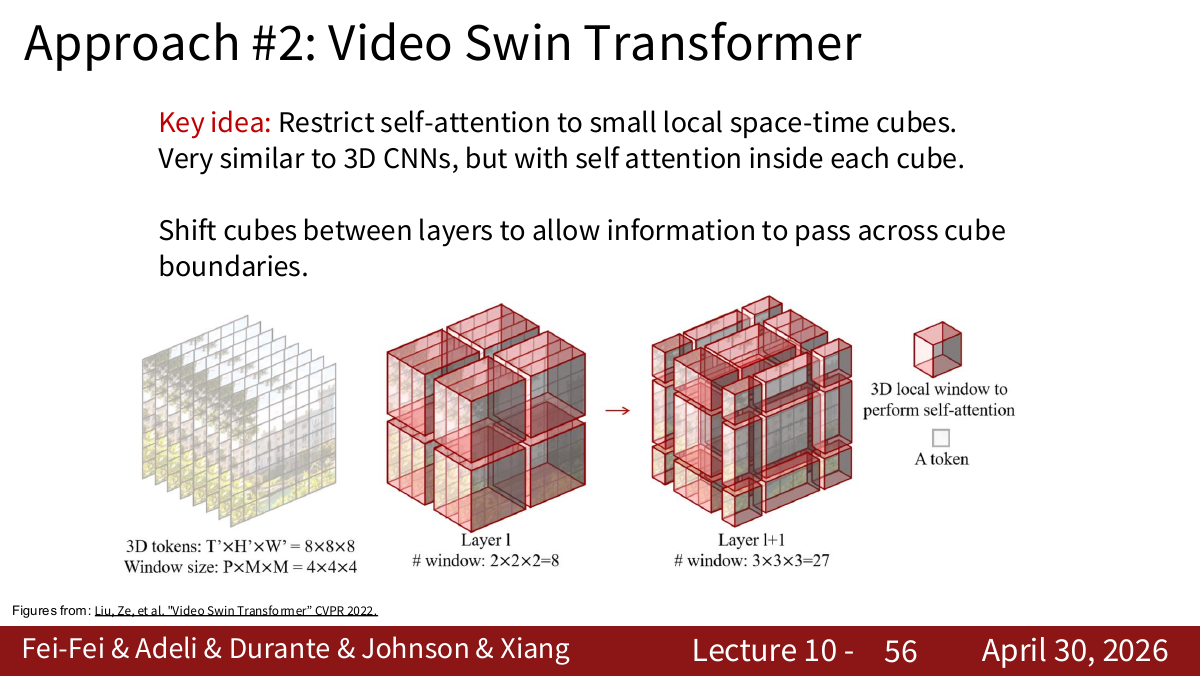
- Video Swin:窗口内局部时空 attention,层间移动窗口。
- MViT:卷积下采样 ,形成多尺度特征。
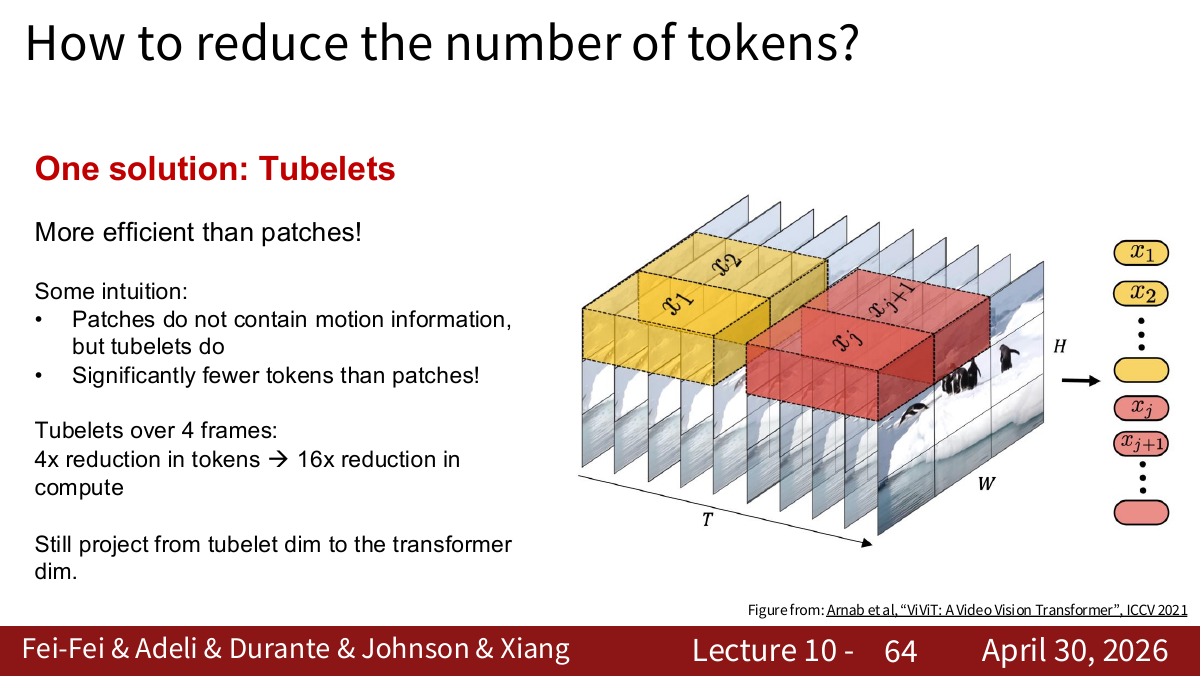
- 减少 token。
- Tubelet 覆盖连续多帧,含局部运动;4 帧 tubelet 将 token 数降 4 倍、全局 attention 计算约降 16 倍。
更细粒度与更长视频
- 时间动作定位:预测未剪辑视频中动作的起止时间。
- 时空检测:每帧定位人/物体并识别动作。
- 音视频理解:音频提供事件和说话人线索,视觉可辅助声源分离。
- Video LLM:视觉 token 接入 LLM,统一视频描述和问答。
长视频的核心不是单纯扩大上下文,而是在有限 token 预算内完成事件采样、检索、记忆和时序推理。均匀抽帧易漏关键事件,保留全帧又不可承受;现有系统在小时级视频理解上仍有明显不足。