


Lec6: 训练卷积网络与卷积网络架构
归一化、Dropout、VGG 与 ResNet,以及初始化、数据增强和迁移学习。
课程导航与课程讲次
课程讲次
文章目录
两条主线:如何搭建 CNN(层、激活函数、架构、初始化)与如何训练 CNN(预处理、增强、迁移学习、超参数)。
归一化层
动机:稳定各层输入分布,加速收敛、对初始化更鲁棒。
LayerNorm:先归一化再用可学习的 缩放平移,逐样本统计、与批大小无关。
区别在于沿哪些维度求统计量(张量 ):
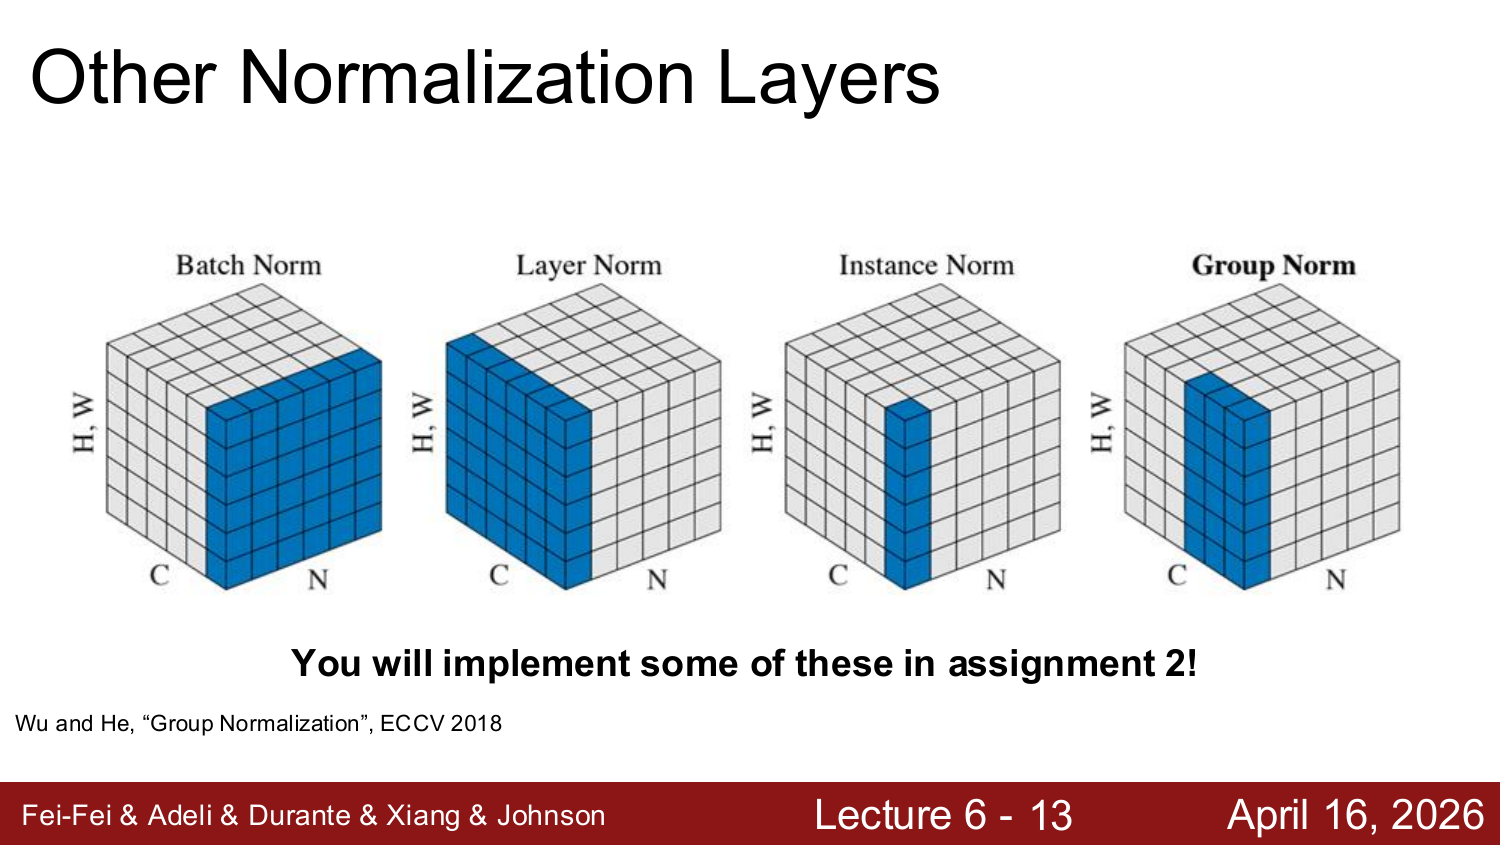
- Batch Norm:每通道跨批与空间;依赖批大小,训练/测试行为不同。
- Layer Norm:每样本跨通道与空间;与批大小无关。
- Instance Norm:每样本每通道跨空间。
- Group Norm:通道分组后跨空间;小批量下替代 BN。
Dropout
每次前向随机把部分神经元置零(丢弃概率常取 )。两种解释:迫使冗余表示、防止特征互相适应;训练共享参数的指数级集成。
测试时所有神经元都用,激活乘以 ,使「测试输出 = 训练输出期望」。(inverted dropout 把缩放挪到训练。)
正则化范式:训练注入随机 ,测试平均掉 。
激活函数
目的:引入非线性,置于线性算子之后。
- Sigmoid:,压到 ;大值处梯度趋零,多层导致梯度消失。
- ReLU:,正区间不饱和、高效、收敛快;但输出非零中心、有死亡 ReLU。
- GELU:,平滑、利于训练,Transformer 常用;成本高。
- 其它:Leaky ReLU、ELU、SiLU。
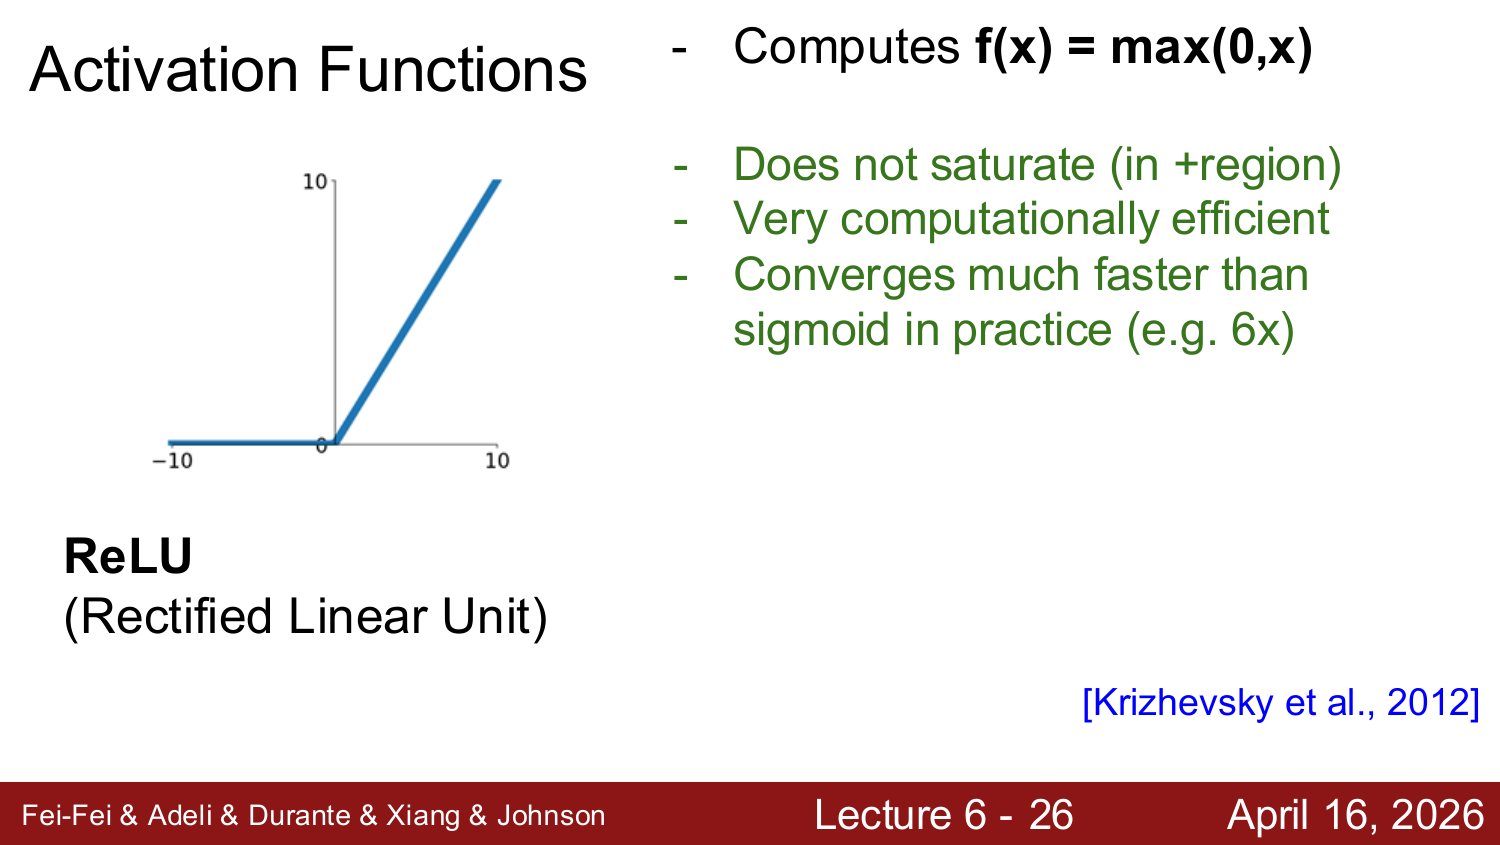
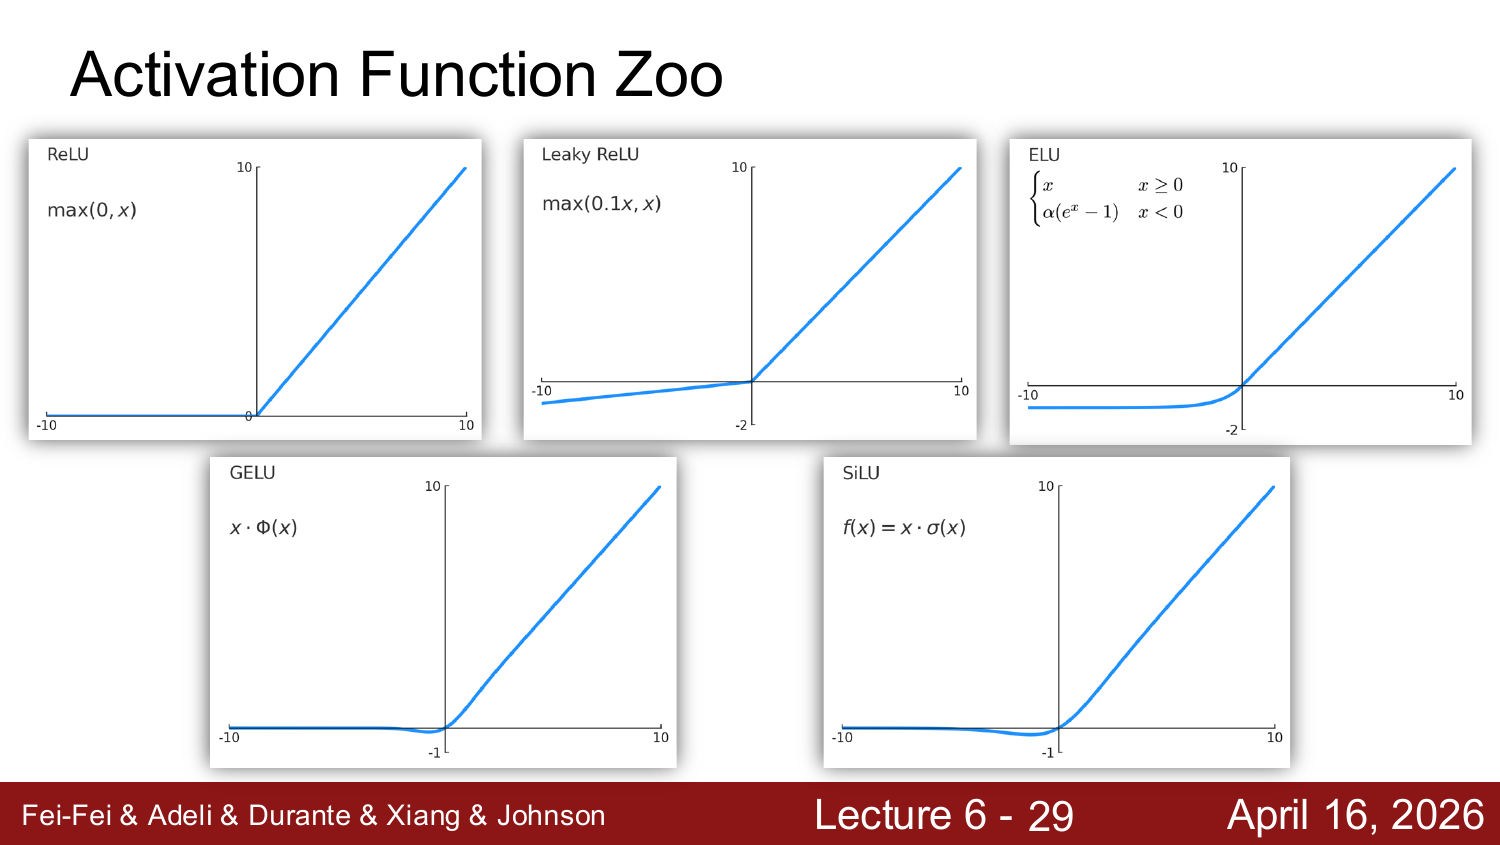
默认用 ReLU。
CNN 架构
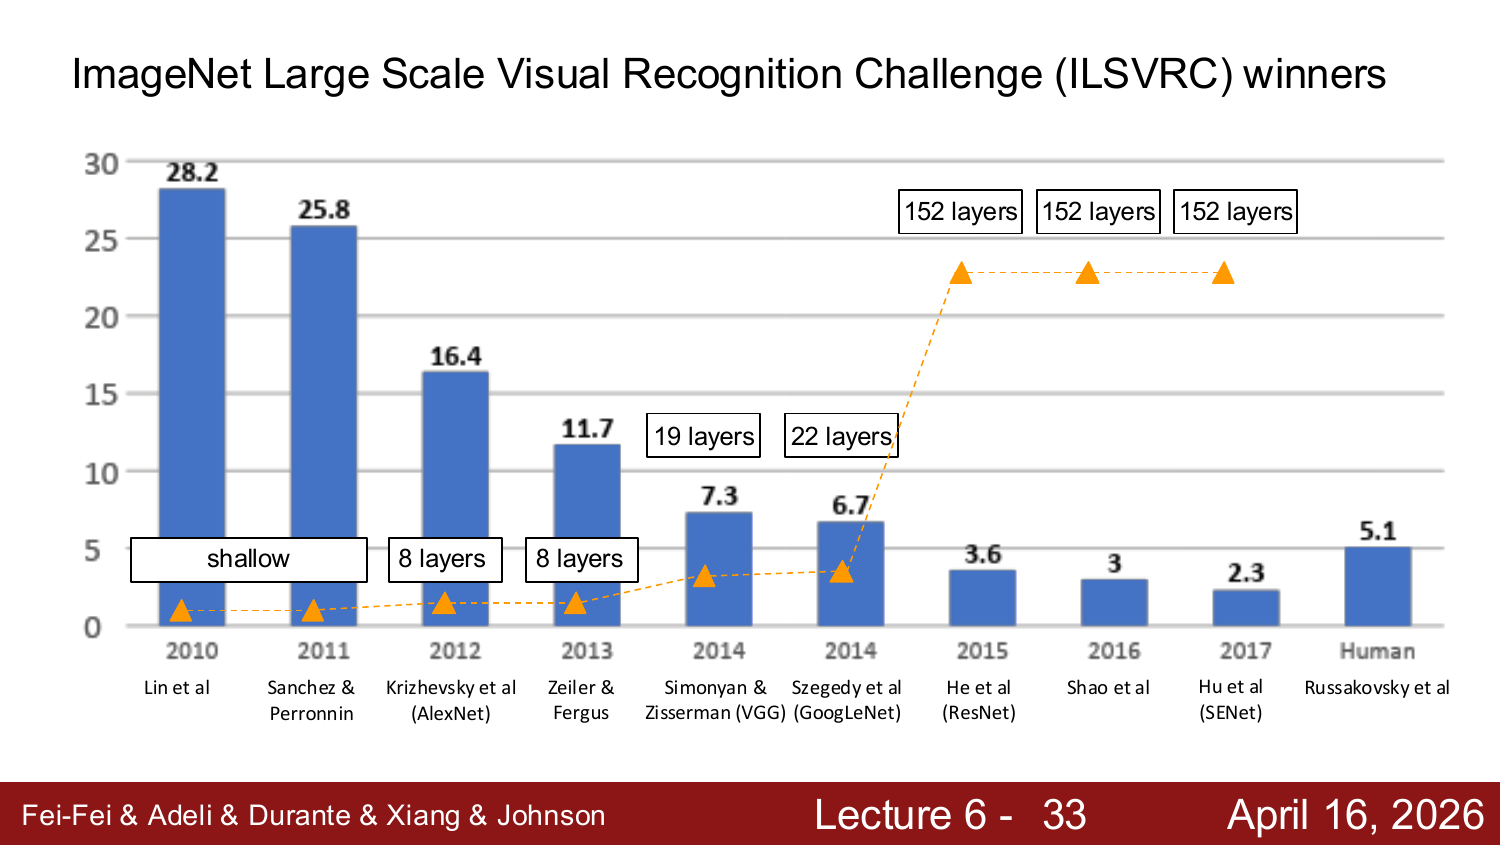
ILSVRC 冠军错误率从 2010 的 28.2% 降到 2017 的 2.3%;2015 ResNet(152 层)带来「深度革命」,已超人类水平 5.1%。
VGGNet
小滤波器、深网络:全部 conv()+ max pool(),16–19 层。
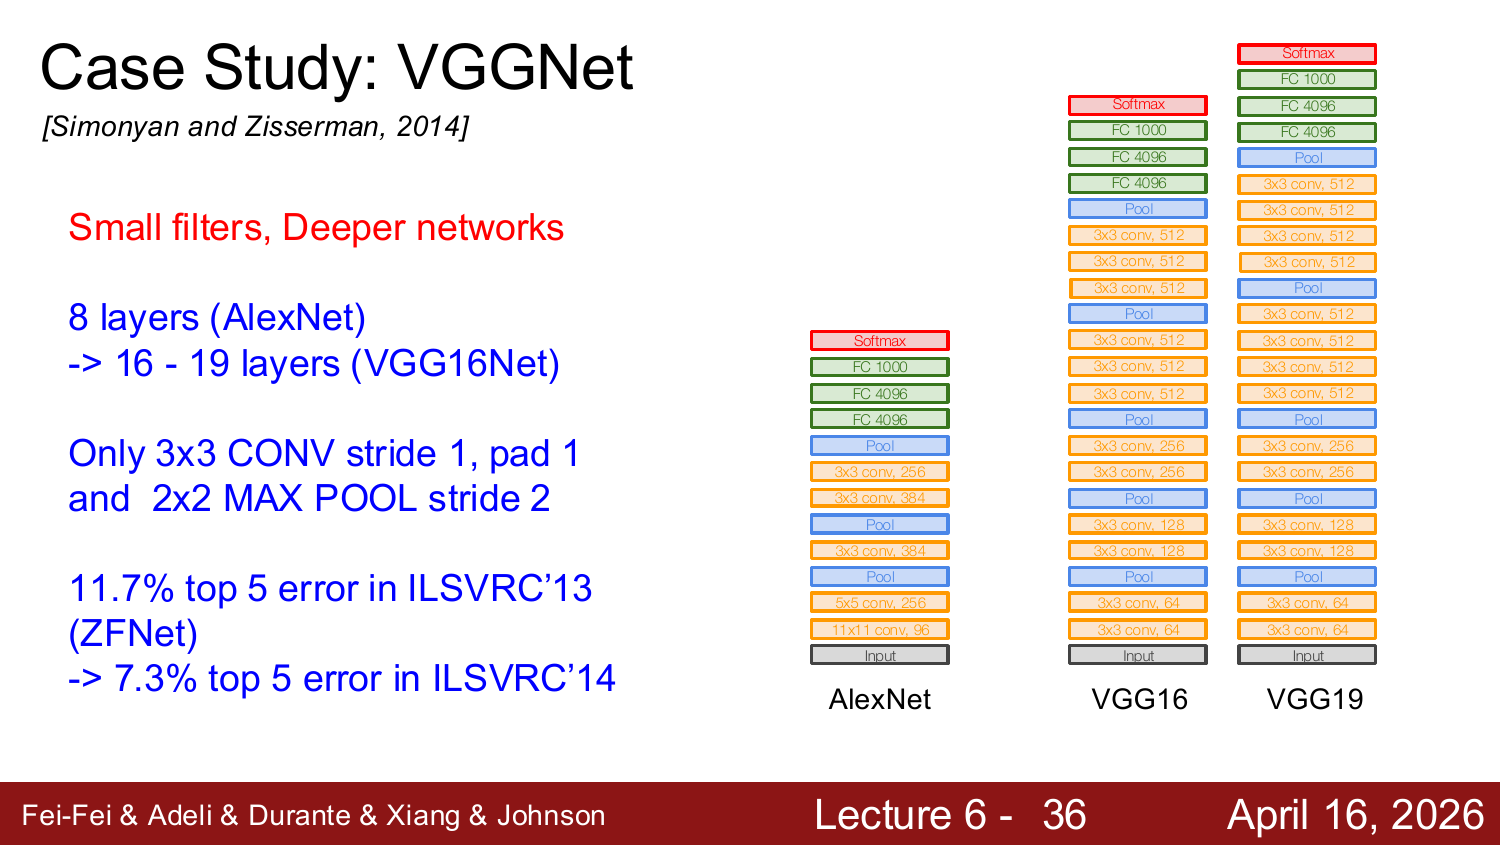
三个 堆叠的有效感受野 = 一个 ,但更深、非线性更多、参数更少( vs )。
ResNet
普通网络堆深后训练误差反而更高 → 不是过拟合,是优化问题:深层难学出恒等映射。
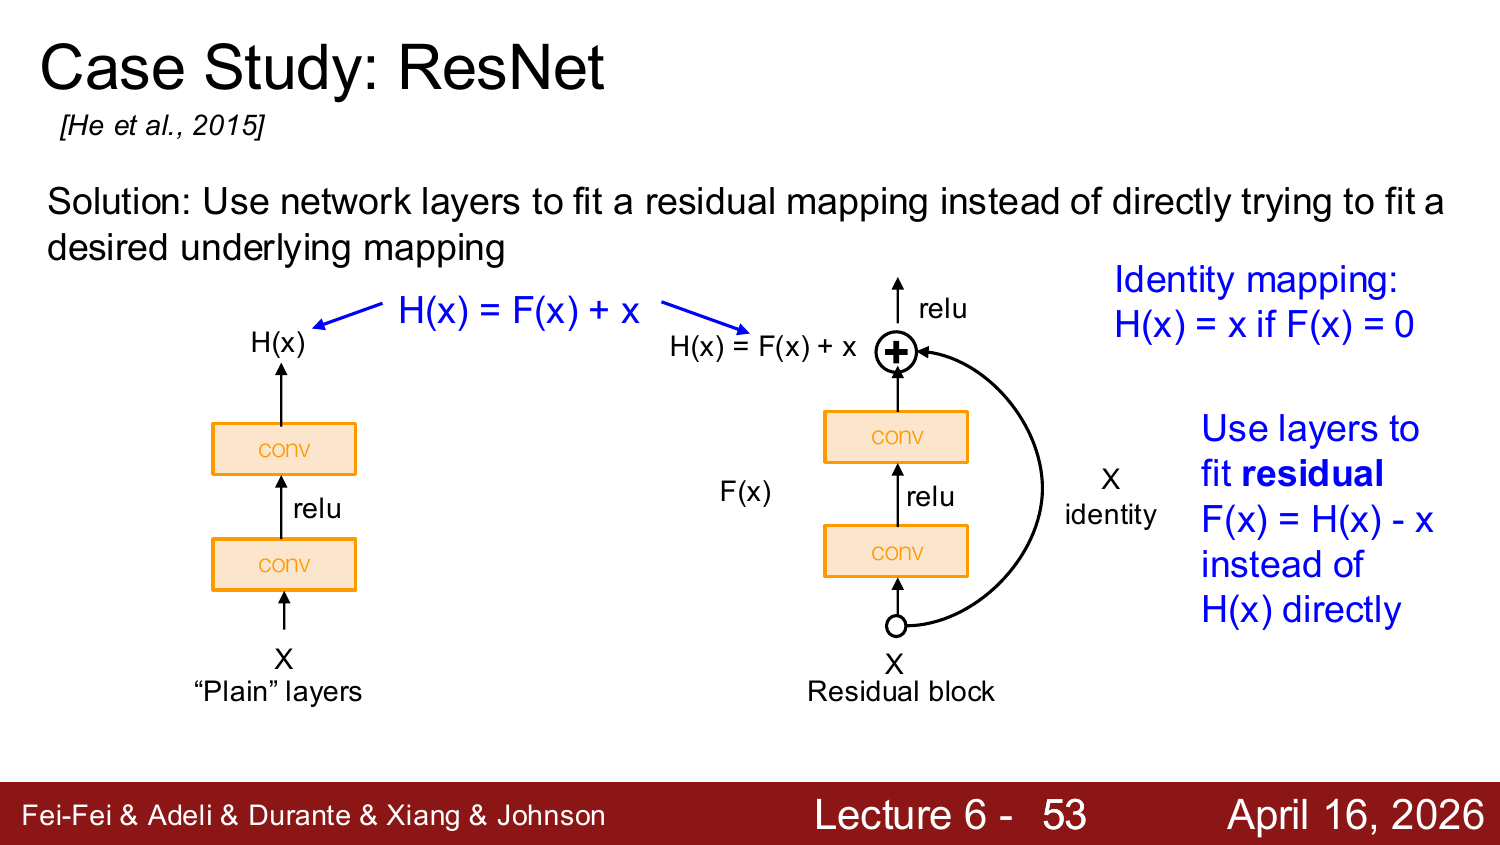
残差块:让层拟合残差 ,输出 。若最优是恒等映射,只需把 学成 0(比学精确恒等容易),捷径也给梯度直达通路。
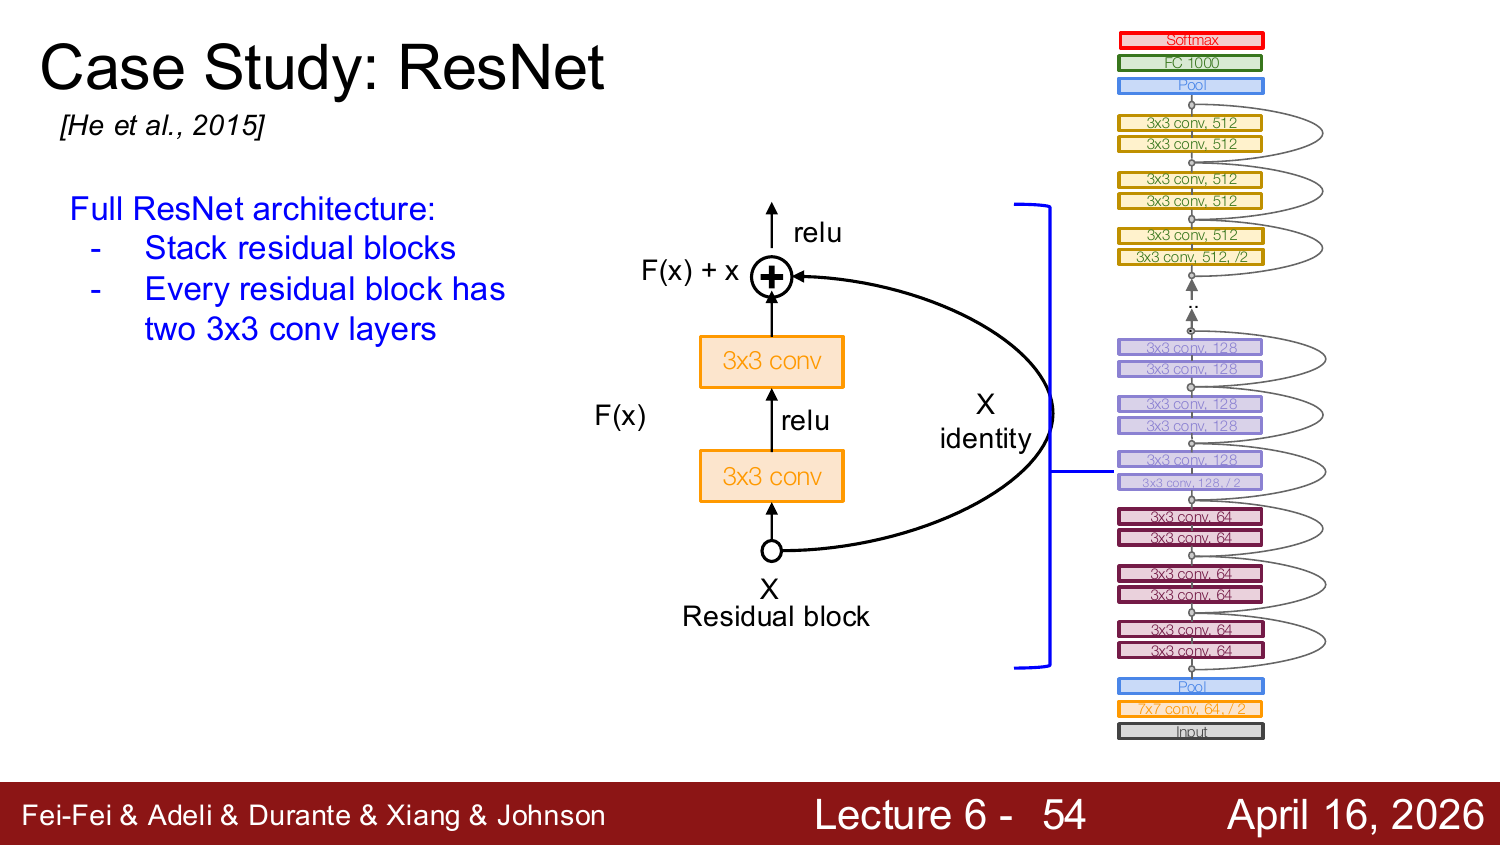
每块两个 conv;周期性翻倍通道并用 stride 2 下采样;开头有 stem。深度 18/34/50/101/152。152 层夺 ILSVRC’15 冠军(top-5 3.57%)。
权重初始化
太小:激活逐层塌缩为 0,梯度消失。太大:激活爆炸。尺度需依赖输入维度 。
Kaiming/MSRA(ReLU):标准差 ,各层激活分布稳定。
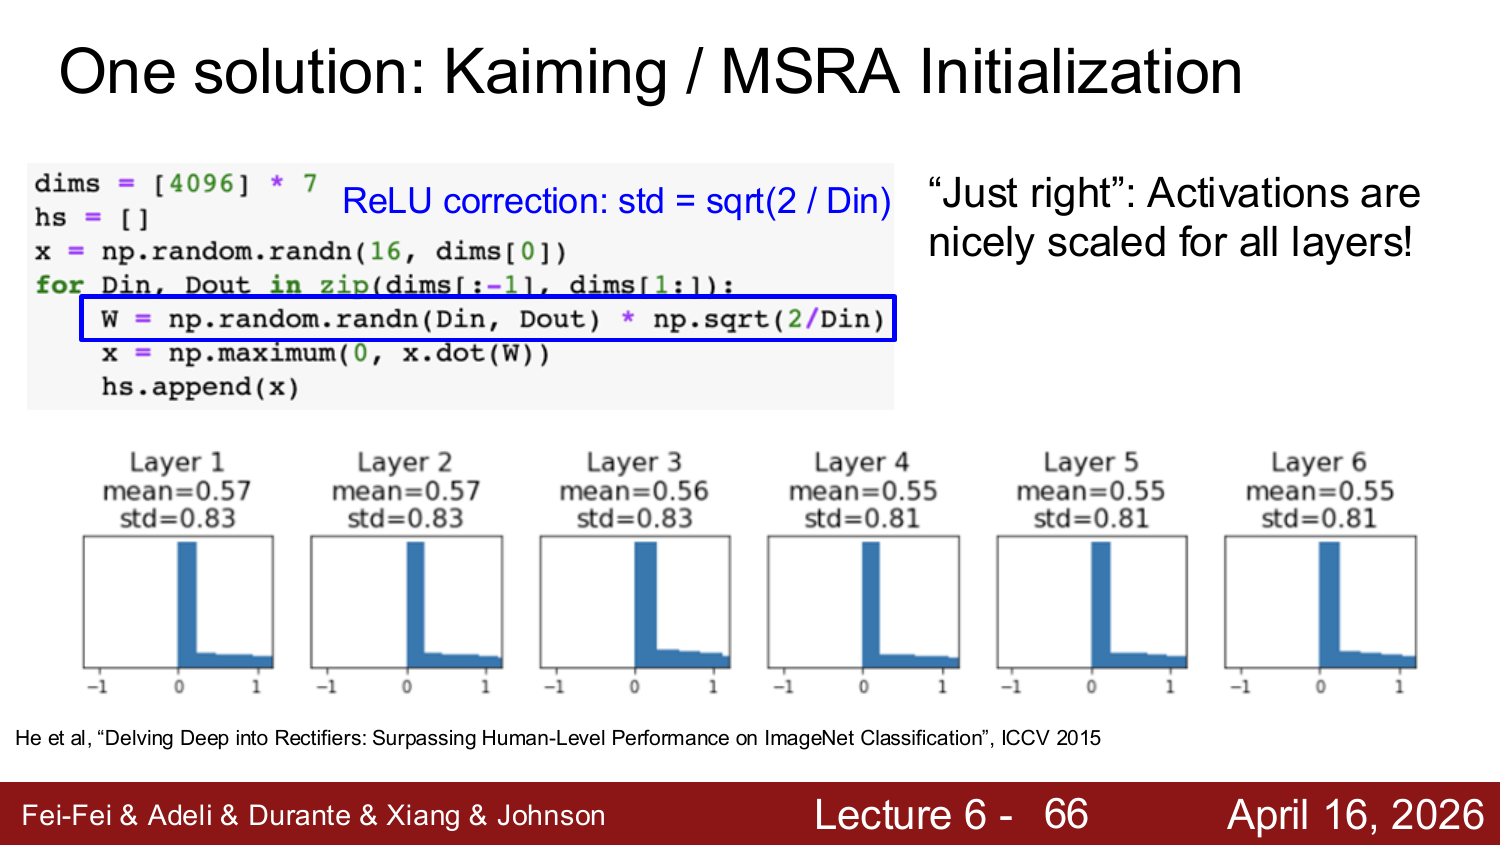
W = np.random.randn(Din, Dout) * np.sqrt(2 / Din)直觉: 抵消方差累加,因子 2 补偿 ReLU 置零一半。原则:让激活分布逐层保持稳定。
数据预处理
逐通道减均值、除标准差(RGB 共 6 个数,训练集预先统计)。
数据增强
训练对图像随机变换、标签不变,测试用原图(正则化范式)。
- 水平翻转。
- 随机裁剪/缩放:ResNet 训练取 缩放短边再裁 ;测试对 5 尺度各 10 裁剪取平均。
- 颜色抖动。
- Cutout:随机区域置零,小数据集(CIFAR)有效。
迁移学习
ImageNet 预训练特征浅层通用、深层专门,可复用。
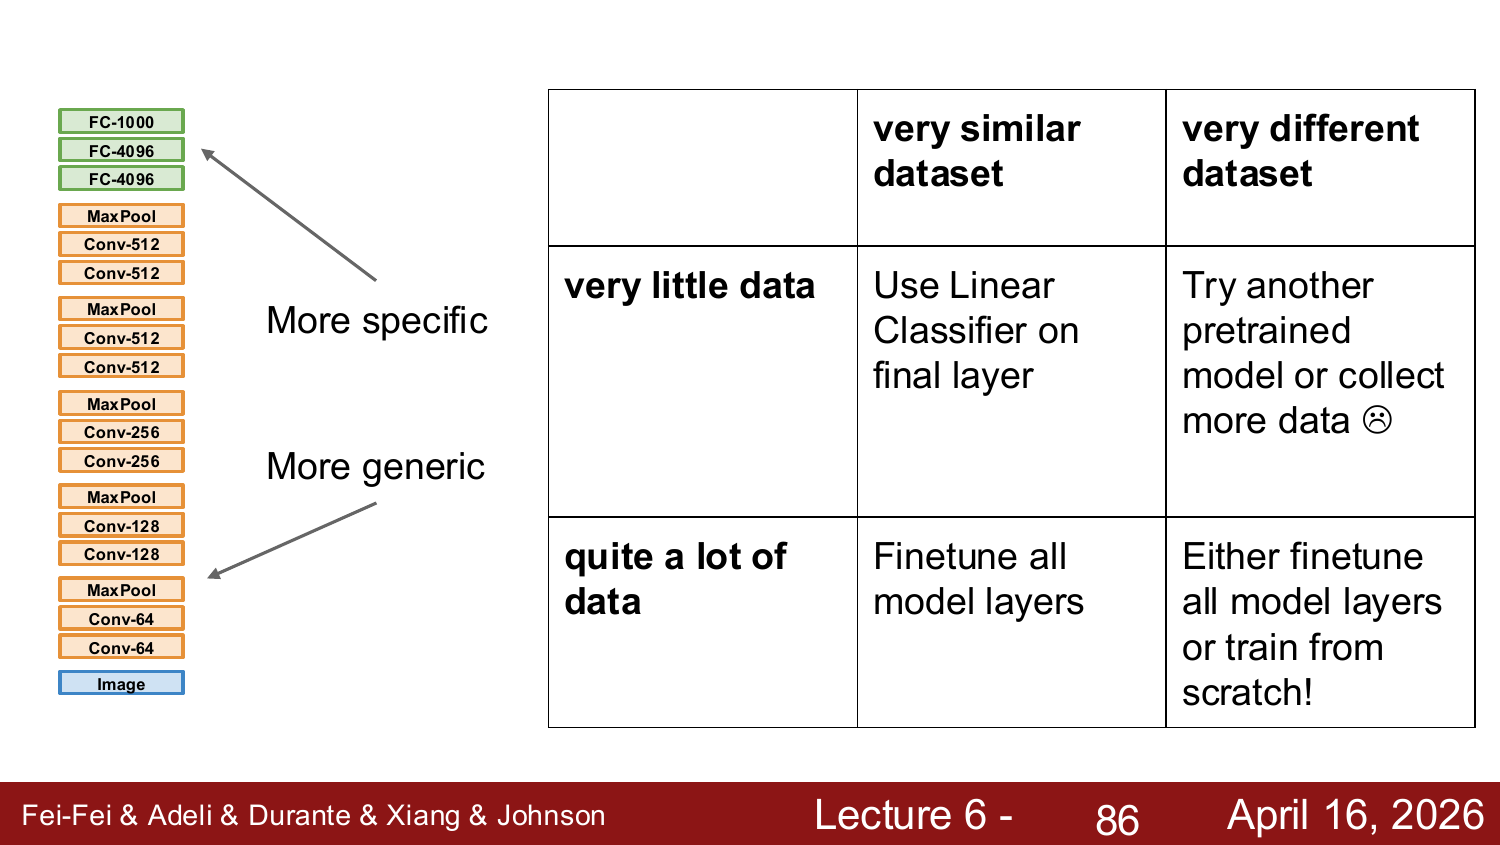
- ImageNet 预训练。
- 小数据集:换最后一层、冻结前面(线性分类器于最终层)。
- 数据多:从预训练权重微调更多层。
策略按「相似度 × 数据量」选择:差异越大复用层越浅,数据越多微调越多。M 图像建议用 Model Zoo(torchvision、timm)。
超参数选择
- 查初始损失(C 类 softmax 约 )。
- 小样本过拟合到 100%。
- 找让损失下降的 LR(试 )。
- 粗网格、训 1–5 epoch。
- 细化网格、训更久。
- 看曲线。7. 回到 5。
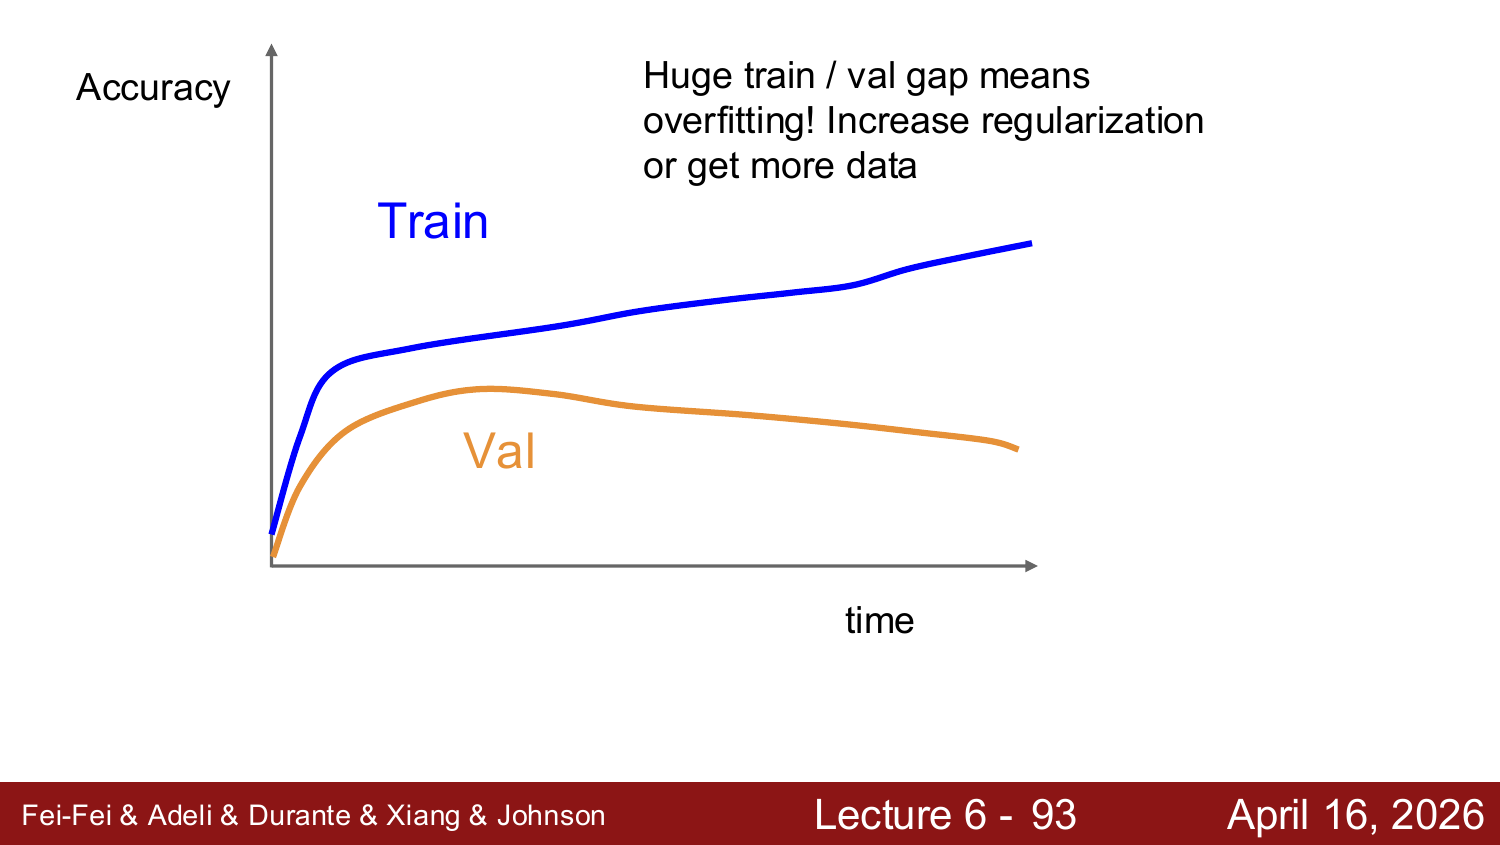
曲线诊断:仍上升→训更久;train/val 差距大→过拟合,加正则或加数据;无差距→欠拟合,训更久或更大模型。
随机搜索优于网格搜索:重要参数只有少数,随机采样在重要维度覆盖更多取值。