


Lec12: 自监督学习
利用无标签数据构造预训练目标,比较 MAE、SimCLR、MoCo 和 DINO。
课程导航与课程讲次
课程讲次
文章目录
自监督学习从无标签数据自动构造训练目标,预训练 encoder,再迁移至有标签下游任务。训练仍使用监督式损失;“自监督”指标签/目标由数据自身给出。
评估
- 线性评估:冻结 encoder,只训练线性头;衡量表示线性可分性。
- 微调:继续更新预训练模型;衡量迁移潜力。
- 不应只看预文本任务准确率,应看下游性能、鲁棒性和成本。
预文本任务
- 旋转预测、拼图、相对 patch 位置:迫使模型学习形状与空间关系。
- 上色、视频着色:从语义和时间一致性恢复颜色,可涌现追踪能力。
- Inpainting:从上下文恢复遮挡区;像素 L2 容易模糊,多模态预测可配合对抗损失。
这些任务需人工设计,且可能只学到任务特化表示。
MAE
图像切为 ViT patch,随机遮掉约 75%。大 encoder 只编码可见 patch;小 decoder 接收编码结果、mask token 和位置编码;只在被遮挡 patch 上算像素 MSE。
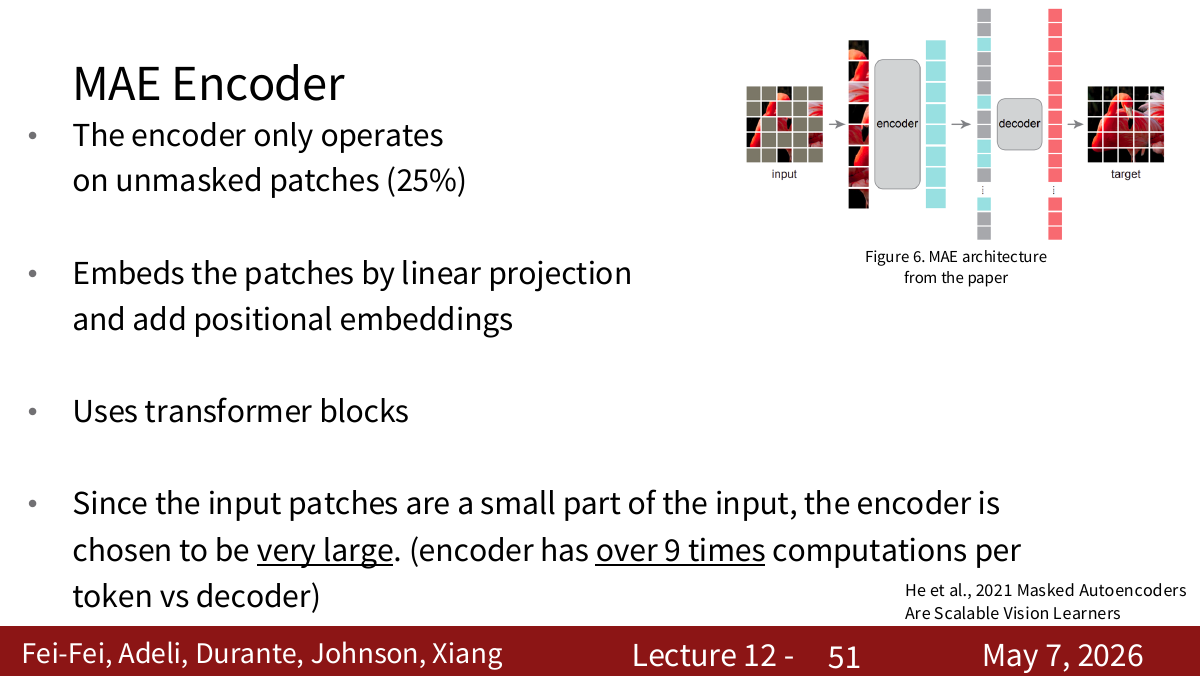
高掩码率使任务不再是局部复制,并减少 encoder attention 成本;预训练后丢弃 decoder。
对比学习
让正对相似、负对不相似。InfoNCE 等价于从正样本和 个负样本中识别正样本:
SimCLR
同一图像的两种强增强构成正对,batch 中其他样本是负对。使用 projection head 在 空间做对比,保留更通用的 供下游使用。强增强、非线性投影头、大 batch 都很关键;大 batch 的内存成本很高。
MoCo
维护 key 的 FIFO 队列作为大量负样本,解耦负样本数与 batch。query encoder 反传更新;key encoder 用动量更新:
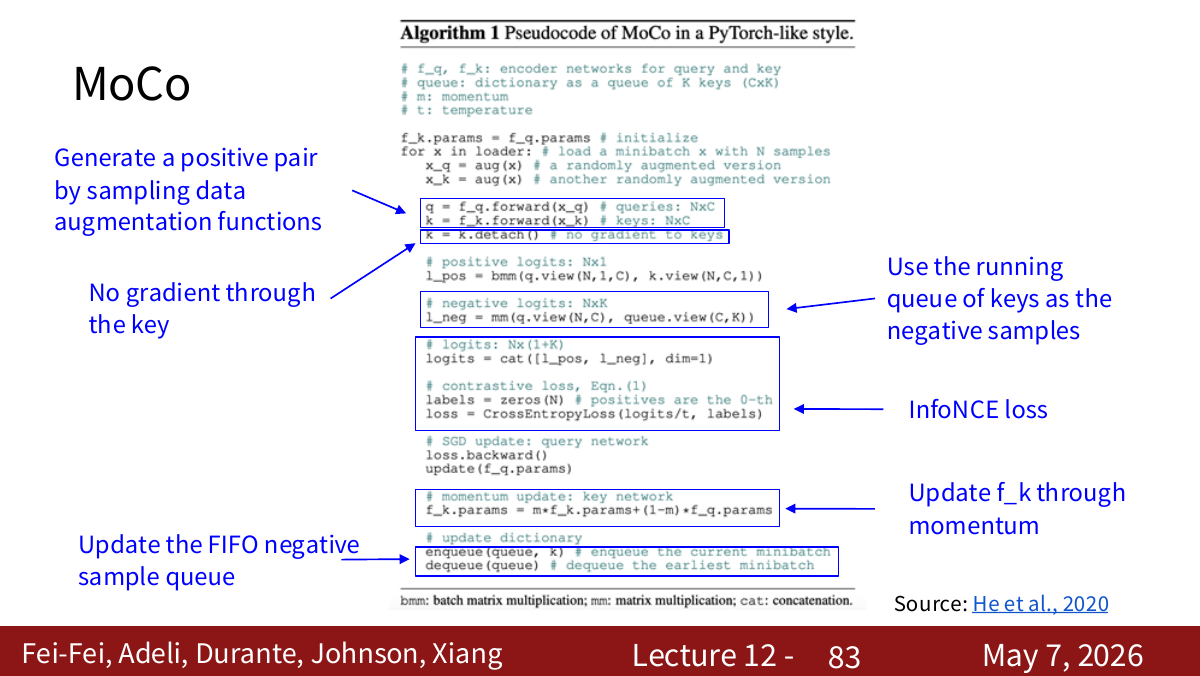
MoCo v2 = MoCo 队列 + SimCLR 强增强和投影头。
CPC 与 DINO
- CPC:由过去上下文 对比预测真实未来表示 ,适合序列。
- DINO:teacher—student 自蒸馏,teacher 是 student 的 EMA;不同裁剪的输出分布对齐,不使用显式负样本。ViT 中常形成语义化 attention。
核心:SSL 的目标不是还原输入或赢得预文本任务,而是学到可迁移、稳健的表征。