


Lec8: 注意力与 Transformer
从序列注意力到多头自注意力、Transformer Block 和 Vision Transformer。
课程导航与课程讲次
课程讲次
文章目录
注意力是作用在「向量集合」上的新原语;Transformer 是处处使用注意力的架构。
RNN seq2seq 的瓶颈
编码器 RNN 把输入压成隐藏状态,从 派生解码器初始状态 和上下文向量 (通常 ),解码器 自回归生成。
问题:整段输入挤过固定大小的 ,长序列()装不下。解决:解码每一步动态回看整个输入。
带注意力的 seq2seq
每个解码步重新计算一个上下文向量,聚焦输入相关部分:
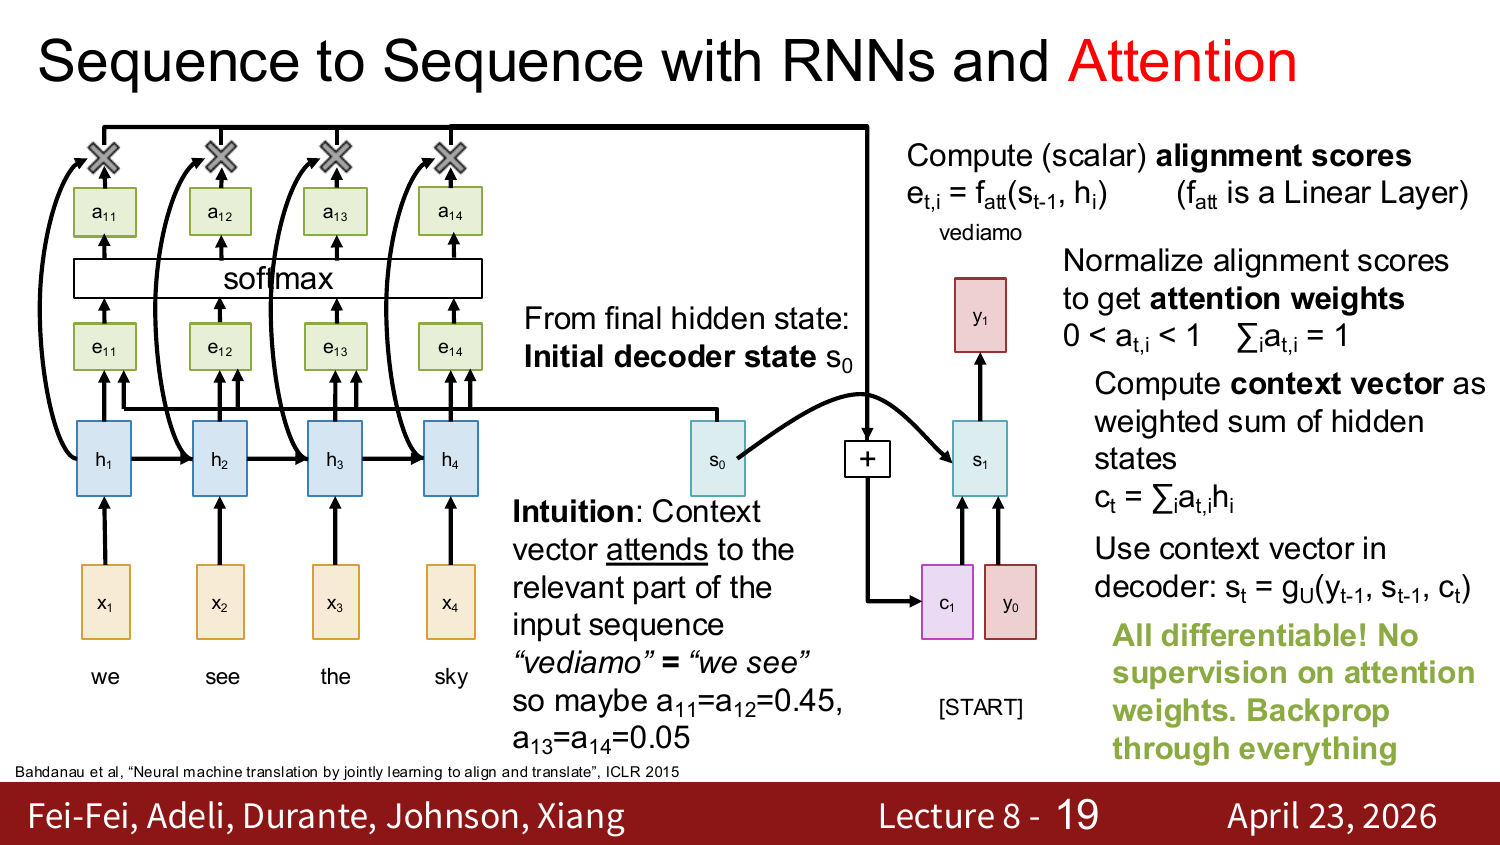
完全可微,对注意力权重无监督,靠翻译损失自己学会对齐。
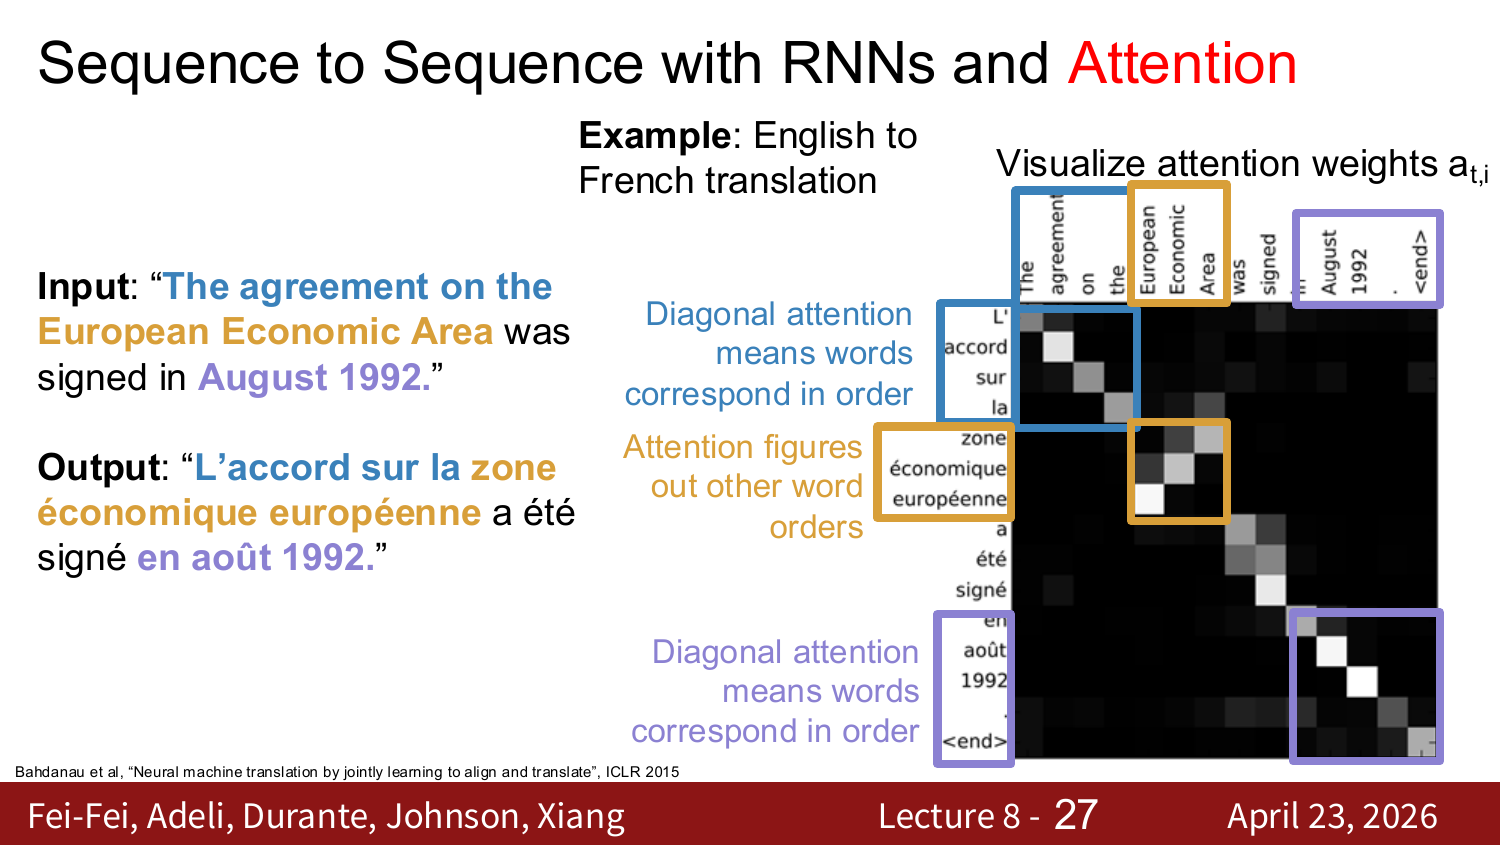
英译法可视化:大致对角(顺序对应),形容词语序相反处出现反对角块,模型自动调换关注顺序。
通用算子:Attention Layer
把 RNN 注意力抽象出来,做三个改动:
- 缩放点积相似度 。除 是因为点积量级随维度增长,过大会使 softmax 饱和、梯度消失。
- 多个查询:()。
- 分离 key/value:,。
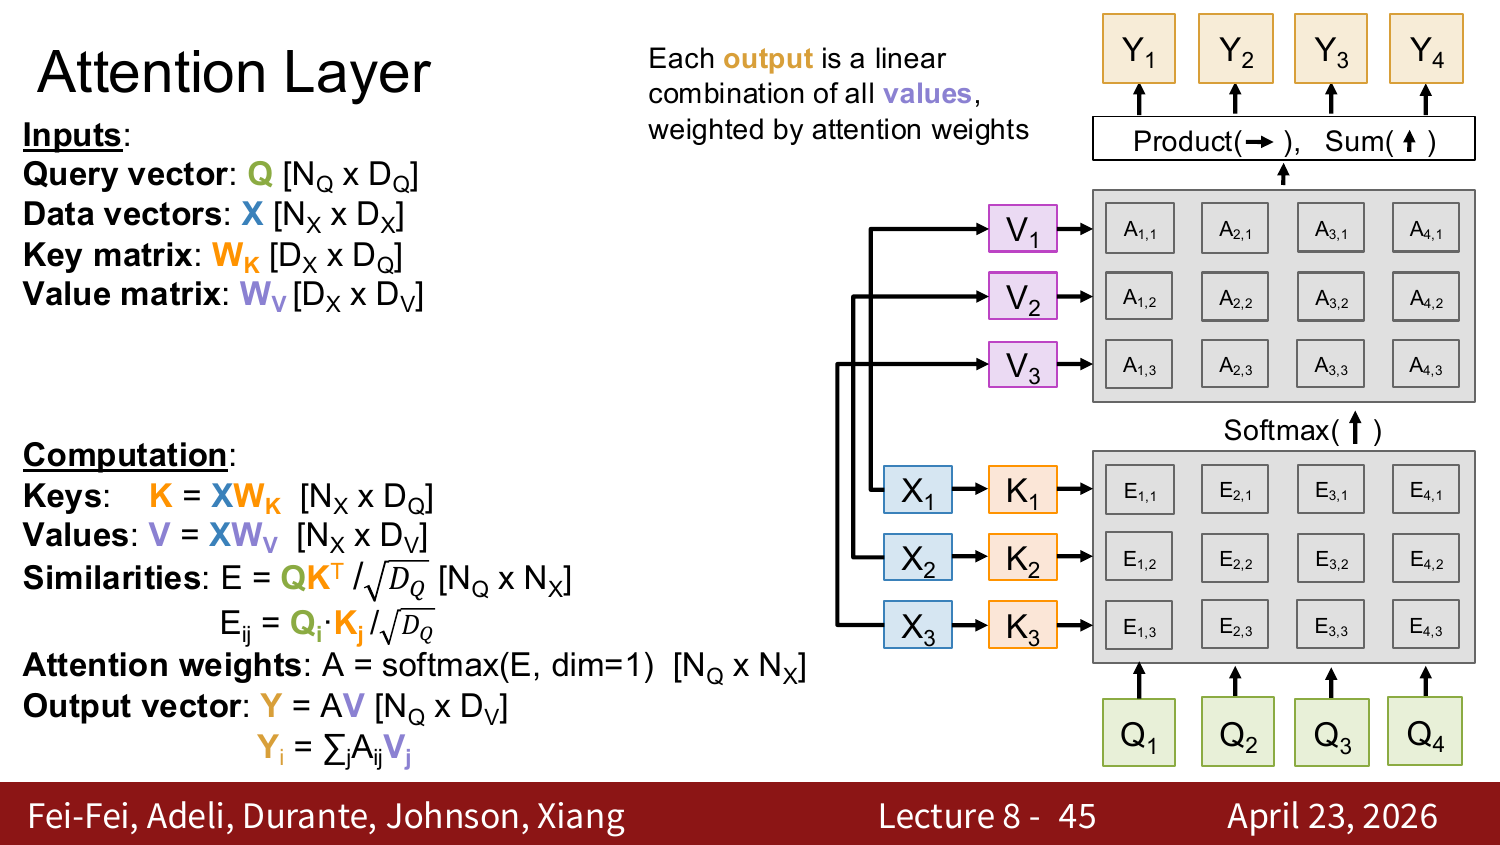
每个查询注意到全部数据向量,输出是值向量按注意力权重的线性组合。
- Cross-attention: 与 来自不同来源(如解码器查询、编码器数据)。
- Self-attention: 都来自同一组输入。
Self-Attention
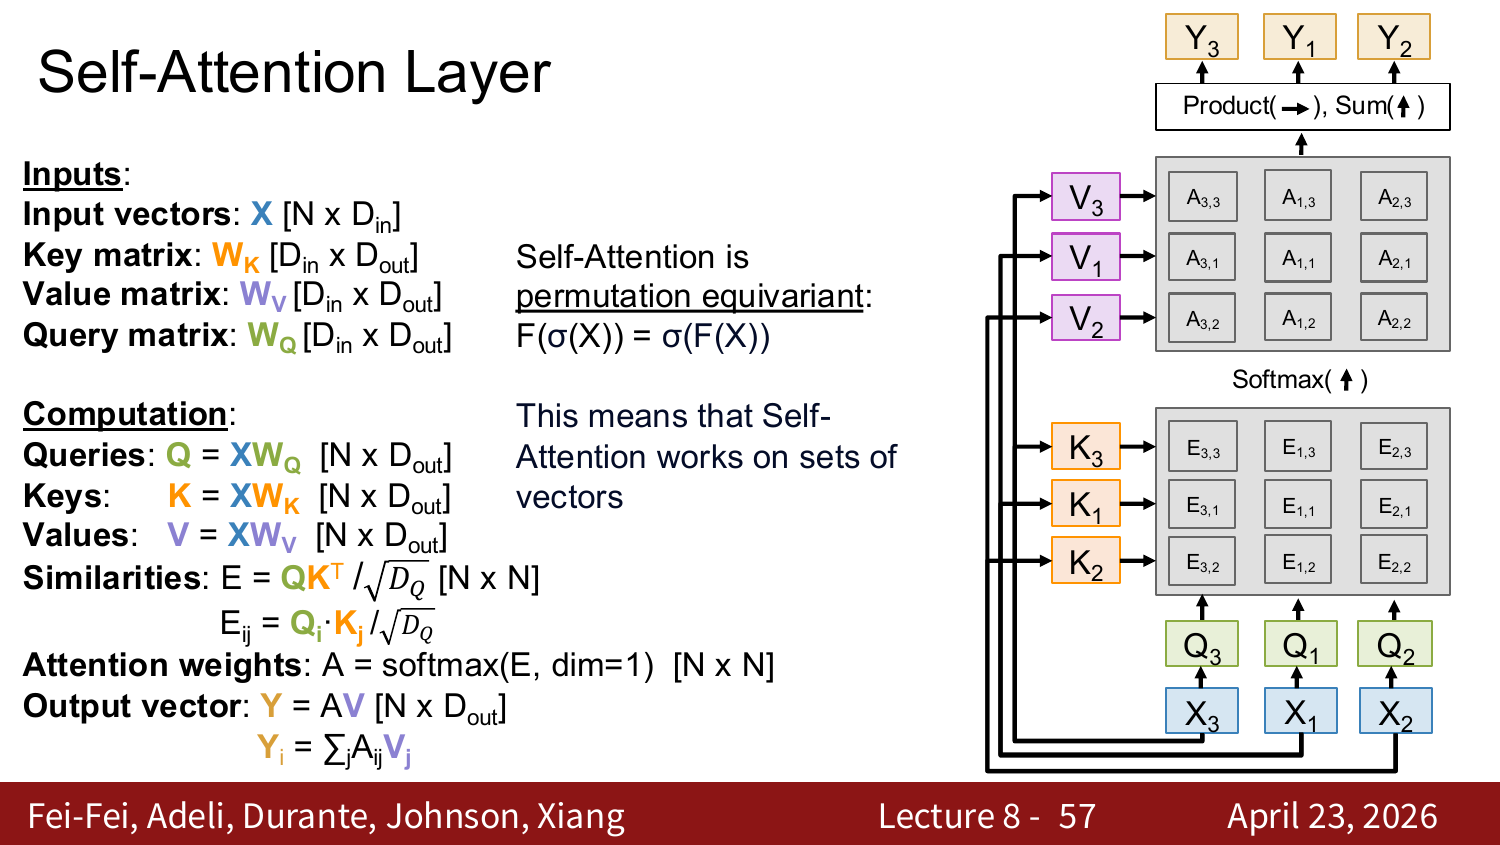
输入 ()经 得 :
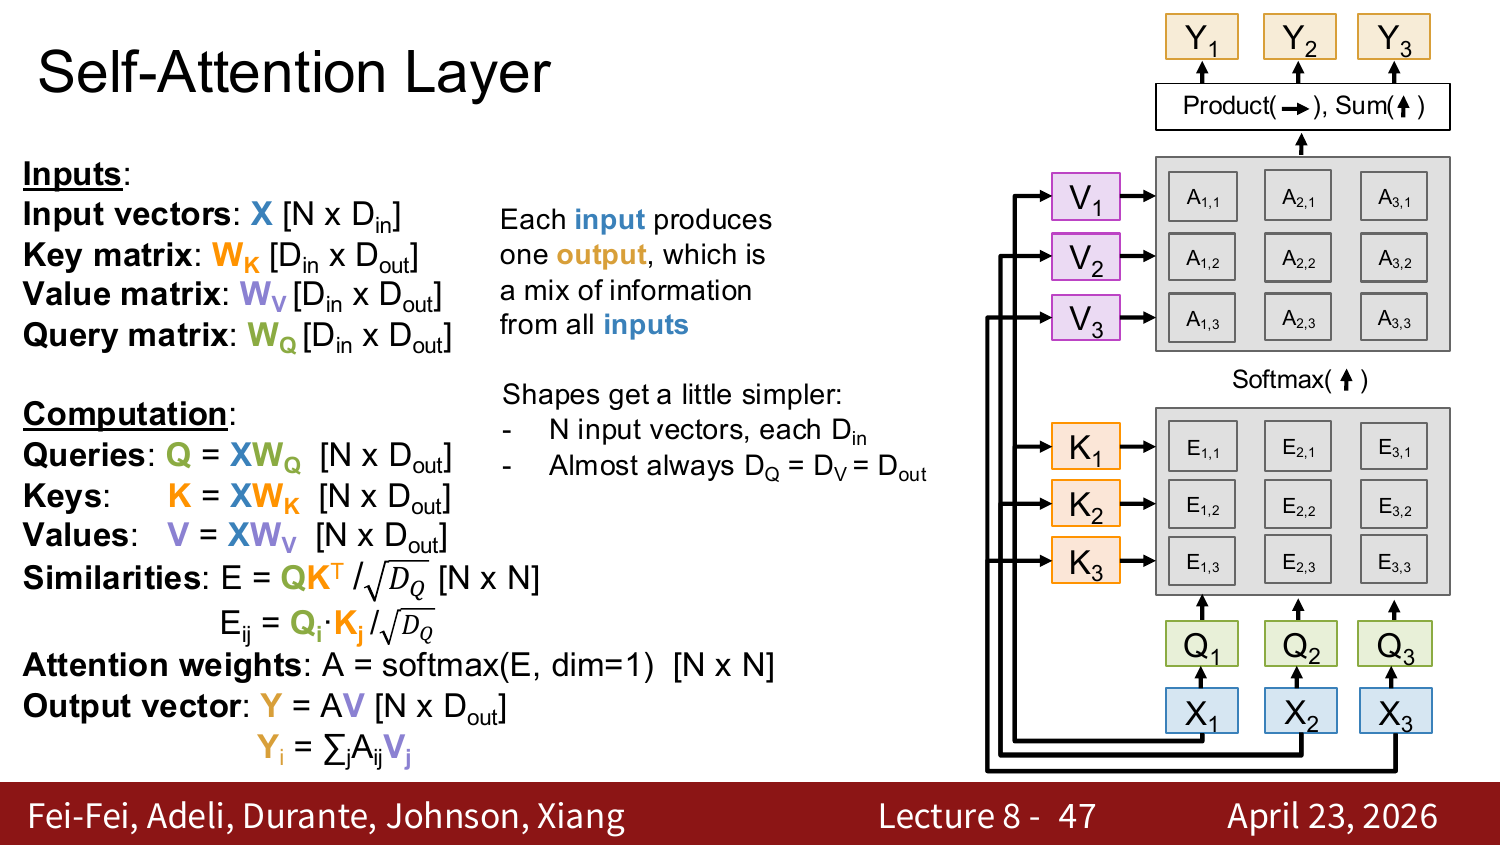
序列内任意位置一层内直接交互,通常 。
排列等变(permutation equivariant):,本质作用在向量集合上、不知顺序。
- 位置编码:给每个输入加位置向量 以感知顺序。RoPE 旋转 Q/K,使点积只依赖相对位置 。
- 掩码自注意力:softmax 前把未来位置的 置 ,权重变 ,用于语言建模(因果掩码)。
多头自注意力
并行跑 个独立的头,各有 ;拼接后用 融合。通常 。
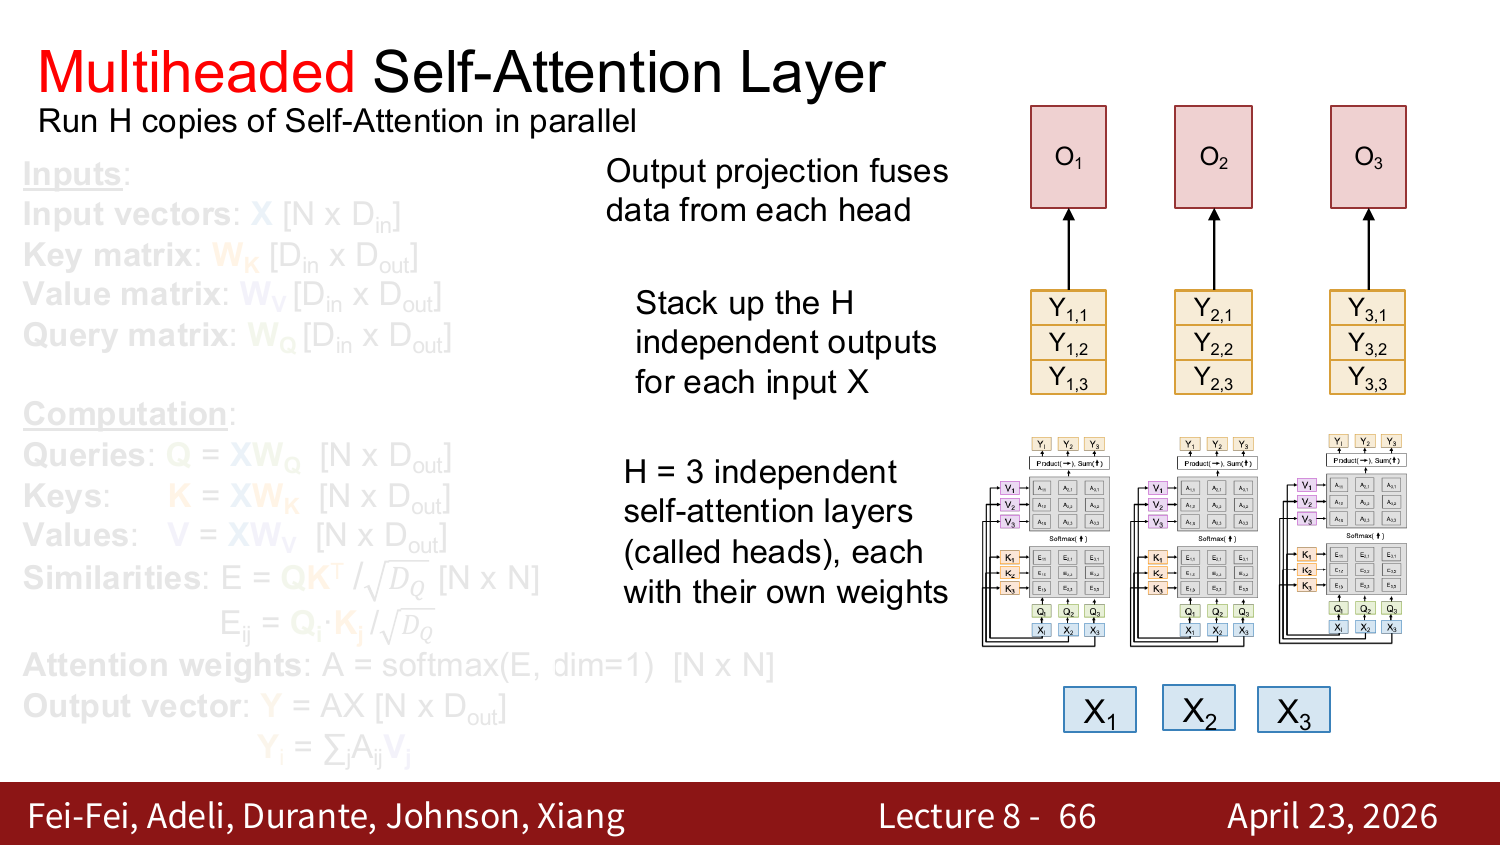
自注意力 = 四次矩阵乘法(QKV 投影、QK 相似度、V 加权、输出投影),高度并行。复杂度随 :计算 、内存 。FlashAttention 不存完整注意力矩阵,内存降到 。
三种序列处理方式
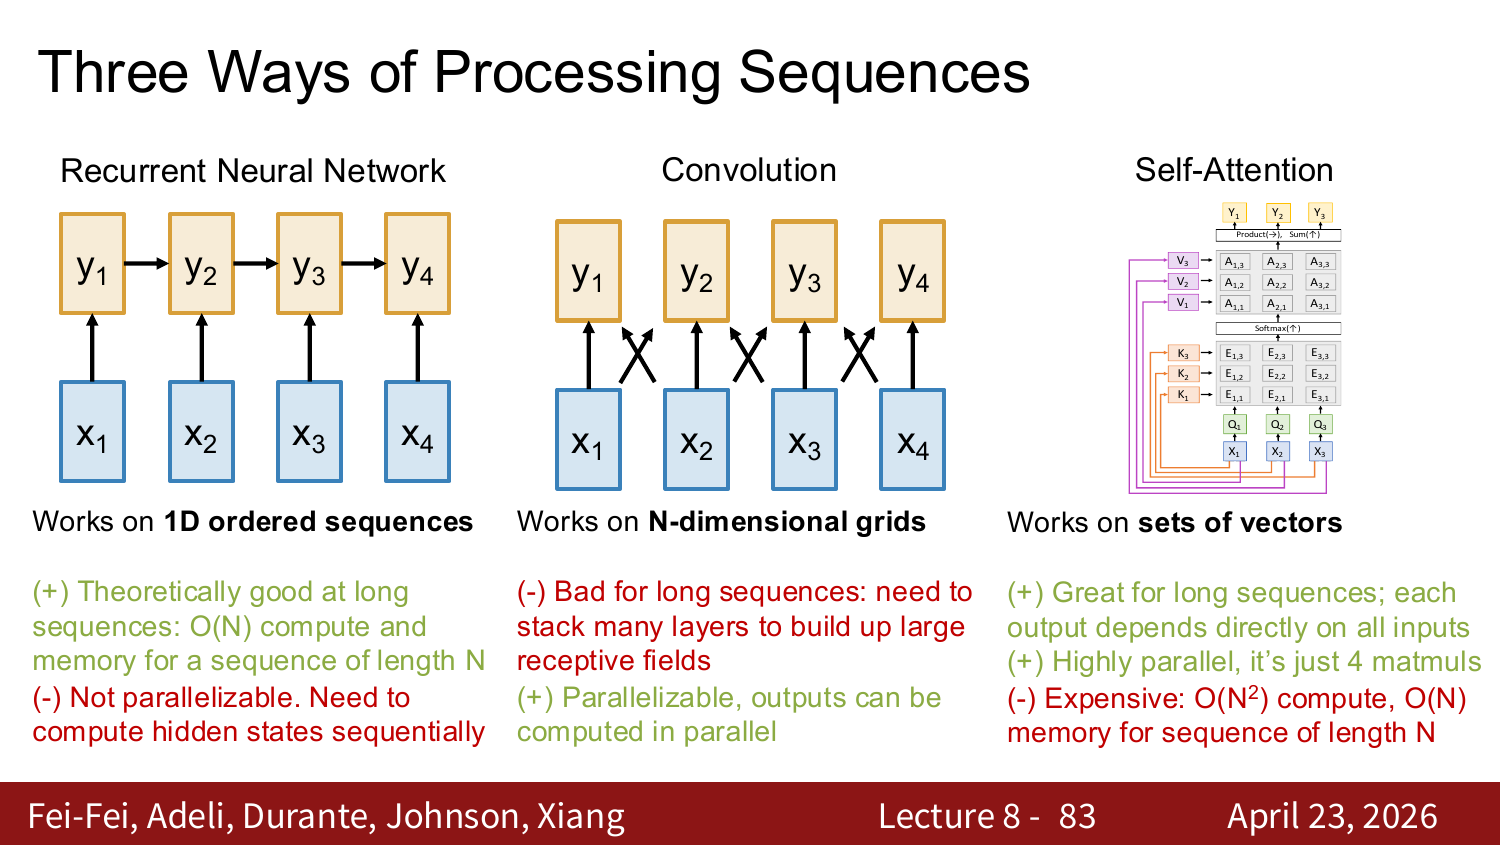
- RNN:一维有序序列,,但串行不可并行。
- 卷积:N 维网格,可并行,但长序列需堆很多层。
- Self-attention:向量集合,每个输出直接依赖所有输入、高度并行,但 计算。
结论:Attention is All You Need(Vaswani et al., 2017)。
Transformer Block
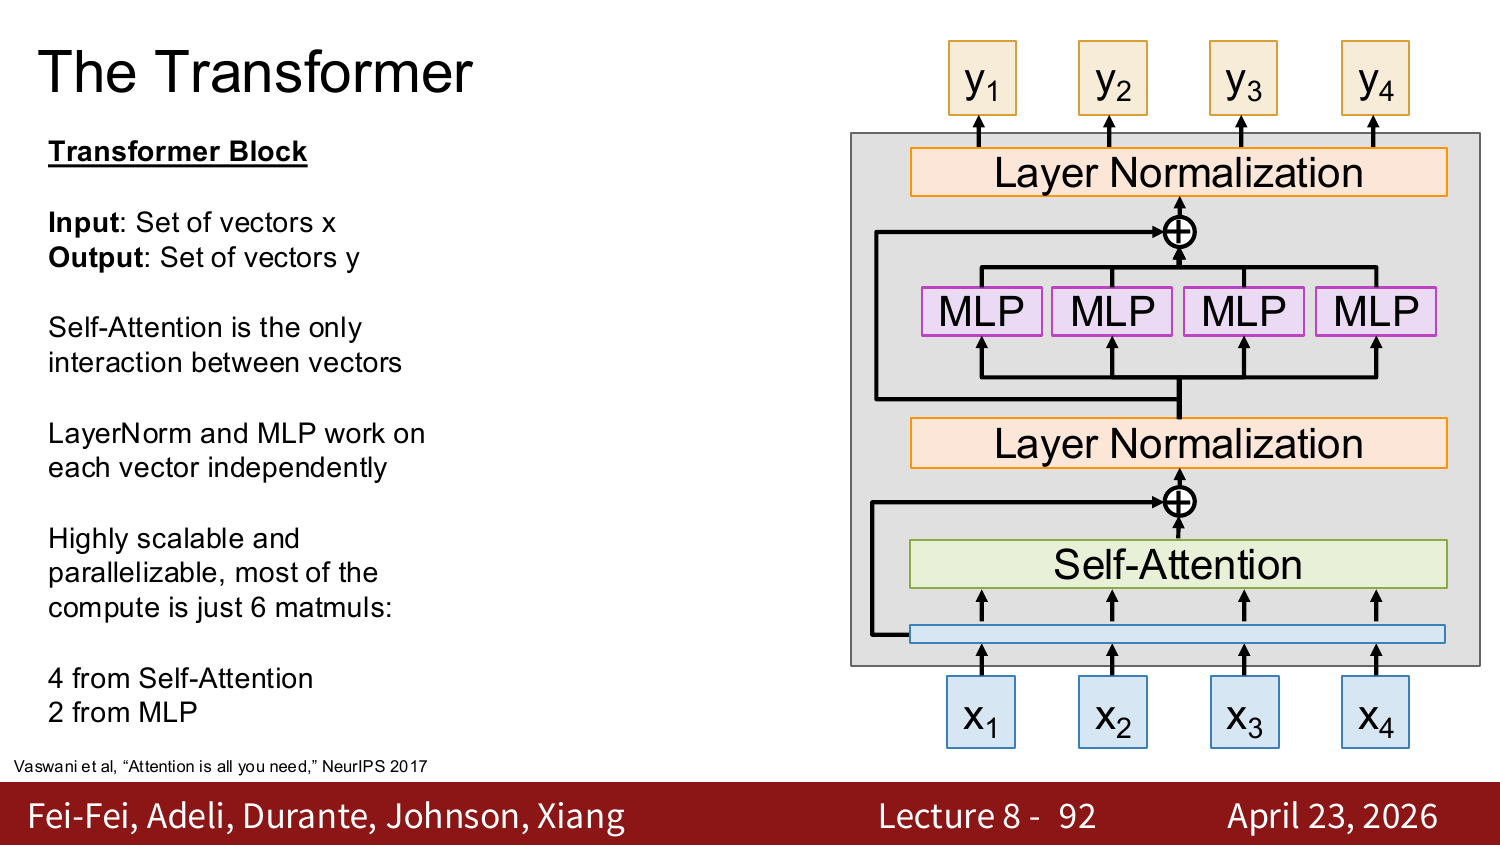
自下而上:多头自注意力 → 残差 → LayerNorm → 逐向量 MLP()→ 残差 → LayerNorm。
自注意力是唯一的跨向量交互;LayerNorm 和 MLP 逐向量独立。主要计算 6 次矩阵乘法(4 自注意力 + 2 MLP)。Transformer = 堆叠相同 block,架构自 2017 基本未变,只是越做越大(原版 213M → GPT-3 175B)。
语言建模:开头嵌入矩阵( 查表),block 内用掩码注意力,结尾投影矩阵()出词表得分,softmax + 交叉熵预测下一 token。
Vision Transformer(ViT)
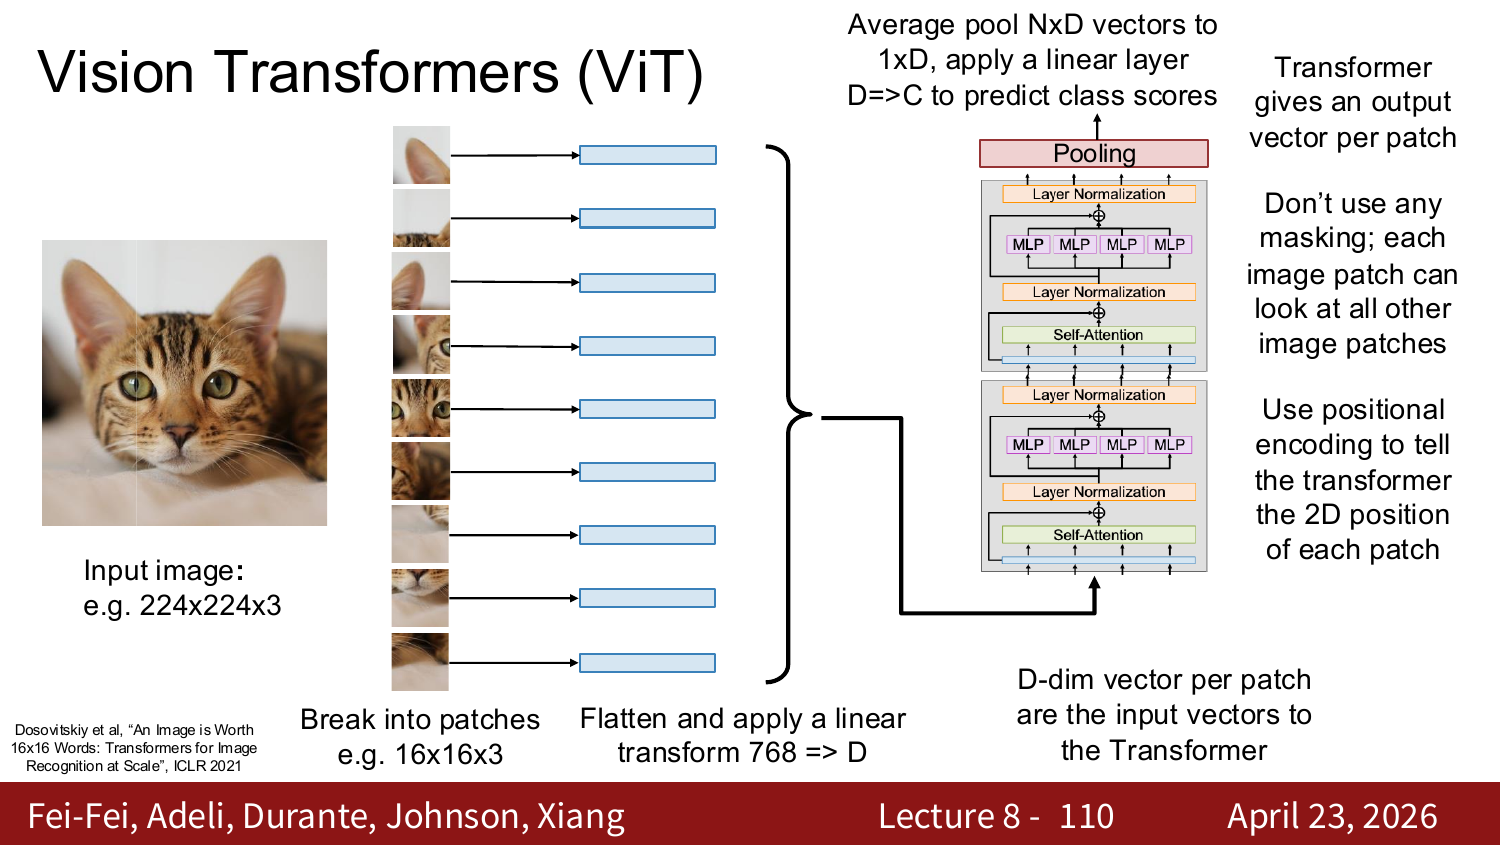
图像切块(如 )→ 展平线性投影成 维向量(等价于 步长 卷积)→ 加二维位置编码 → 送入 Transformer(无掩码,patch 互看)→ 平均池化 + 线性层预测类别。把图像组织成向量集合即可复用 Transformer。
常见改动
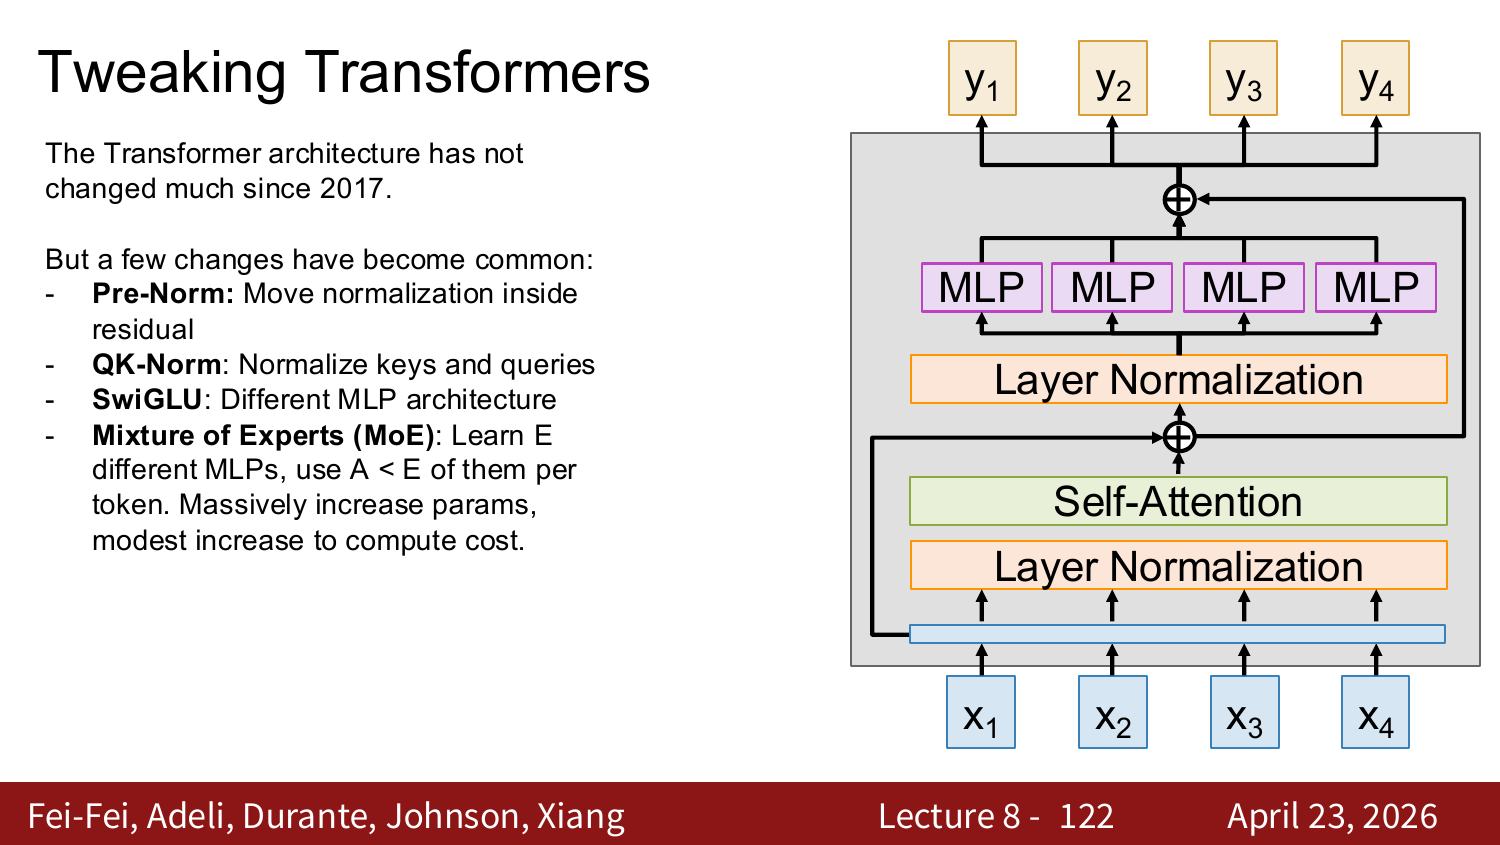
- Pre-Norm:LayerNorm 移到残差连接内部(自注意力/MLP 之前),训练更稳定。
- QK-Norm:相似度前归一化 Q、K(常用 RMSNorm),防梯度尖峰。
- SwiGLU MLP:,门控形式, 保持参数量。
- MoE:每 block 学 套 MLP(专家),每 token 只路由到 个激活。参数增 倍、计算只增 倍。