生成与判别#
- 判别模型:学习 p(y∣x),主要用于分类等映射任务。
- 生成模型:学习 p(x);条件生成模型学习 p(x∣y),处理“一种条件对应多种合理输出”的歧义。
密度满足 ∫p(x)dx=1,不同样本竞争概率质量;这使生成模型能对异常输入赋予低密度。Bayes 公式:
p(y∣x)=p(x)p(x∣y)p(y).
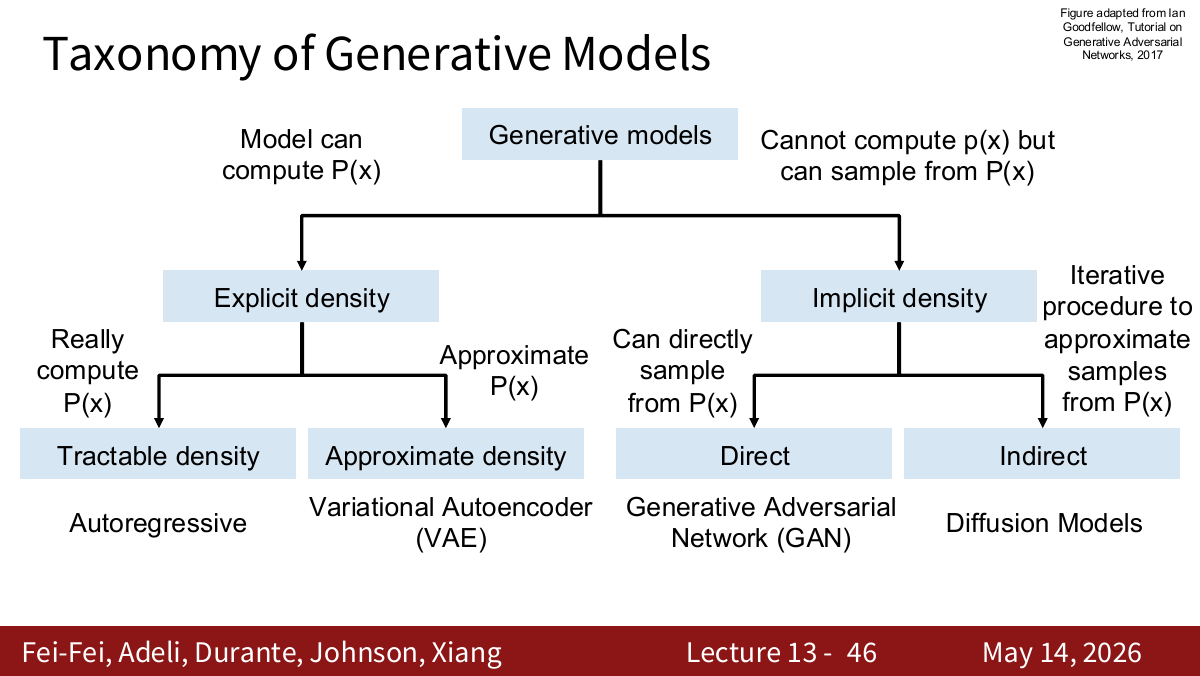
生成模型图谱#
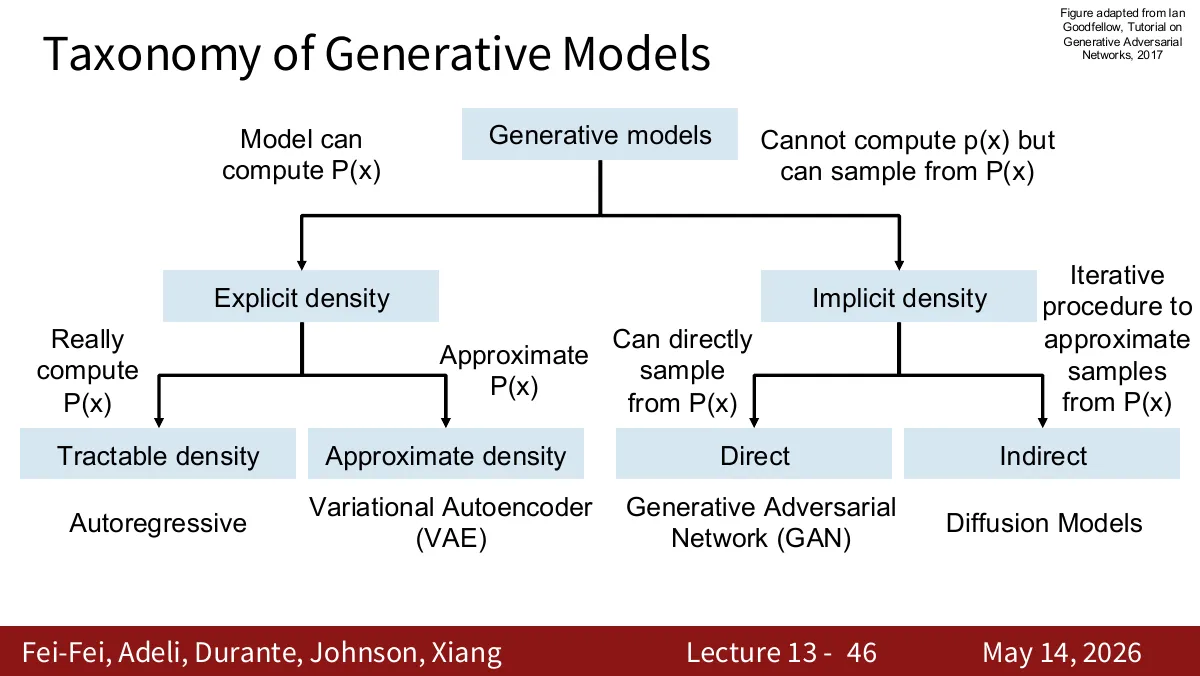
- 显式、可精确求密度:自回归。
- 显式、近似求密度:VAE。
- 隐式、直接采样:GAN。
- 隐式、迭代采样:扩散。
最大似然与自回归#
θ∗=argθmaxi∏pθ(x(i))=argθmaxi∑logpθ(x(i)).对序列:
pθ(x)=t=1∏Tpθ(xt∣x<t).RNN / 因果 Transformer 参数化每项。训练可并行计算所有 next-token 损失,采样必须自回归串行。图像按 RGB 子像素建模会极长,现代方法常先转为更短的离散 latent token。
Autoencoder 与 VAE#
普通 AE:z=eϕ(x)、x^=dθ(z),最小化 ∥x−x^∥22。它能学习表示,但任意采样 z 不一定合理。
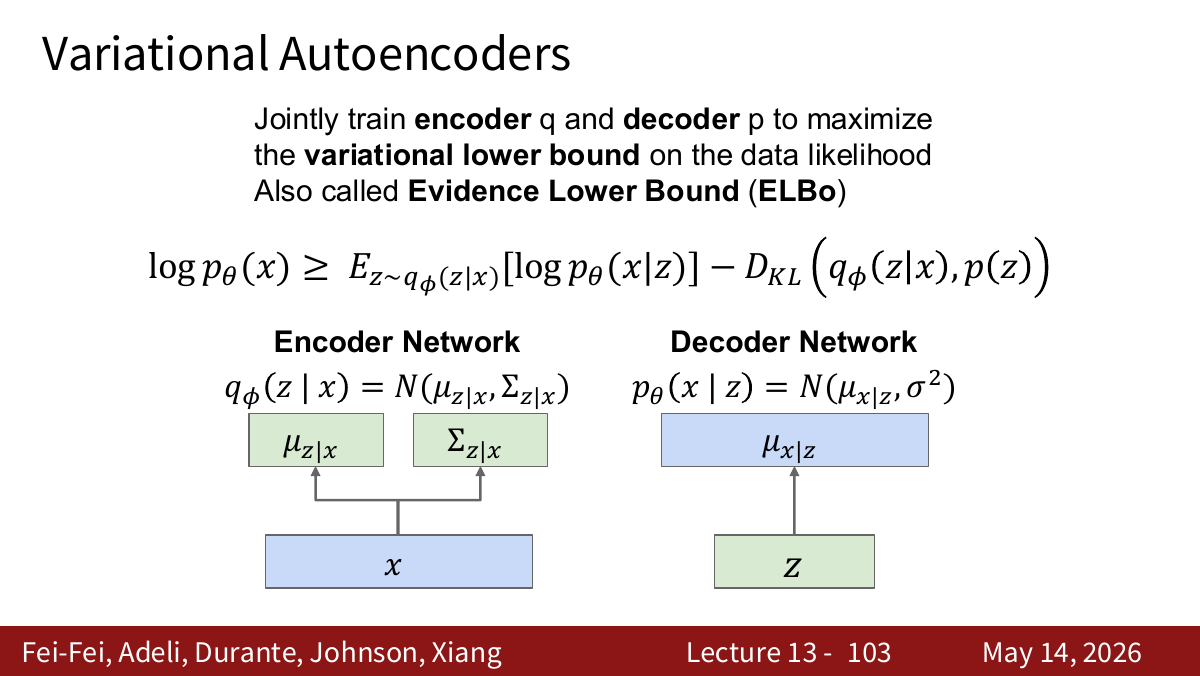
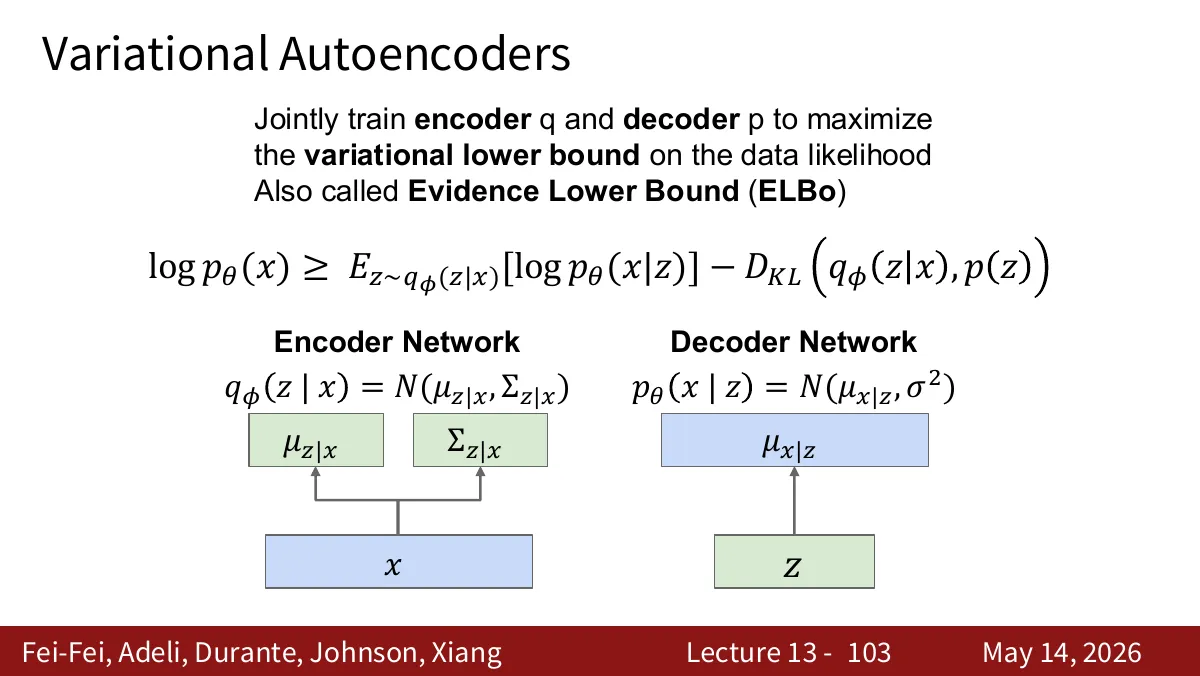
VAE 指定 p(z)=N(0,I) 与 decoder pθ(x∣z)。生成:采样 z 后解码。因
pθ(x)=∫pθ(x∣z)p(z)dz难算,引入近似后验 qϕ(z∣x)。
ELBO:
logpθ(x)≥Eqϕ(z∣x)[logpθ(x∣z)]−DKL(qϕ(z∣x)∥p(z)).第一项是重建,第二项让编码分布匹配可采样先验。两项互相拉扯:重建希望每样本编码唯一,KL 希望编码接近同一标准高斯。
对角高斯 encoder:
qϕ(z∣x)=N(μϕ(x),diag(σϕ2(x))).重参数化使采样可反传:
ϵ∼N(0,I),z=μϕ(x)+σϕ(x)⊙ϵ.