


Lec9: 检测、分割、可视化与理解
比较语义分割、目标检测与实例分割,理解 DETR 和视觉模型可解释性。
课程导航与课程讲次
课程讲次
文章目录
视觉任务
- 分类:整图输出一个类别。
- 语义分割:逐像素预测类别,不区分同类实例。
- 目标检测:输出可变数量的 。
- 实例分割:每个目标再输出一个像素掩码。
语义分割
滑动窗口逐像素分类会重复计算重叠区域。FCN 用整图卷积一次输出 分数图;困难是编码器下采样损失空间分辨率。
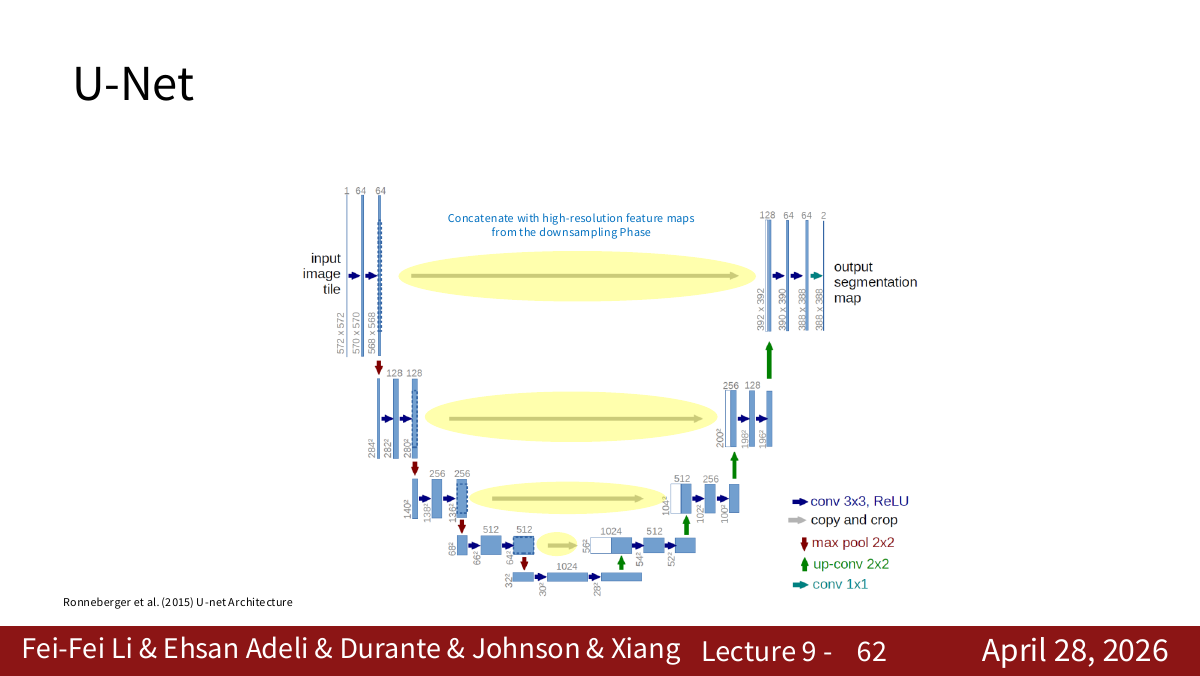
解决:编码器—解码器。编码器下采样获得语义与大感受野;解码器上采样恢复尺寸;末端逐像素交叉熵监督。
- 最近邻 / bed-of-nails:无参数上采样。
- 转置卷积:把输入值加权的卷积核写入更大输出并在重叠处相加;不是普通卷积的逆,可能有棋盘格伪影。
- U-Net:解码层拼接对应编码层的高分辨率特征,结合浅层定位细节和深层语义。
目标检测
单目标定位用共享特征分出分类与框回归头:
两阶段:R-CNN 系列
- R-CNN:外部方法提出约 2K 个 RoI;每个 RoI 独立跑 CNN,极慢。
- Fast R-CNN:整图先过 backbone,在特征图上 Crop + Resize 每个 RoI,复用卷积计算。
- Faster R-CNN:RPN 在每个特征位置的多种 anchor 上预测 objectness 和框偏移;RPN 取代外部 proposal。
单阶段:YOLO / SSD / RetinaNet
在网格/多尺度特征图上直接预测类别、框偏移和置信度,速度快。密集背景造成类别不均衡,RetinaNet 用 focal loss 降低容易样本权重:
DETR
固定数目的 object query 经 Transformer 直接产生一组框和类别;使用 Hungarian 二分图匹配对应预测框与 GT 框,因此不需要 anchor、proposal、NMS。
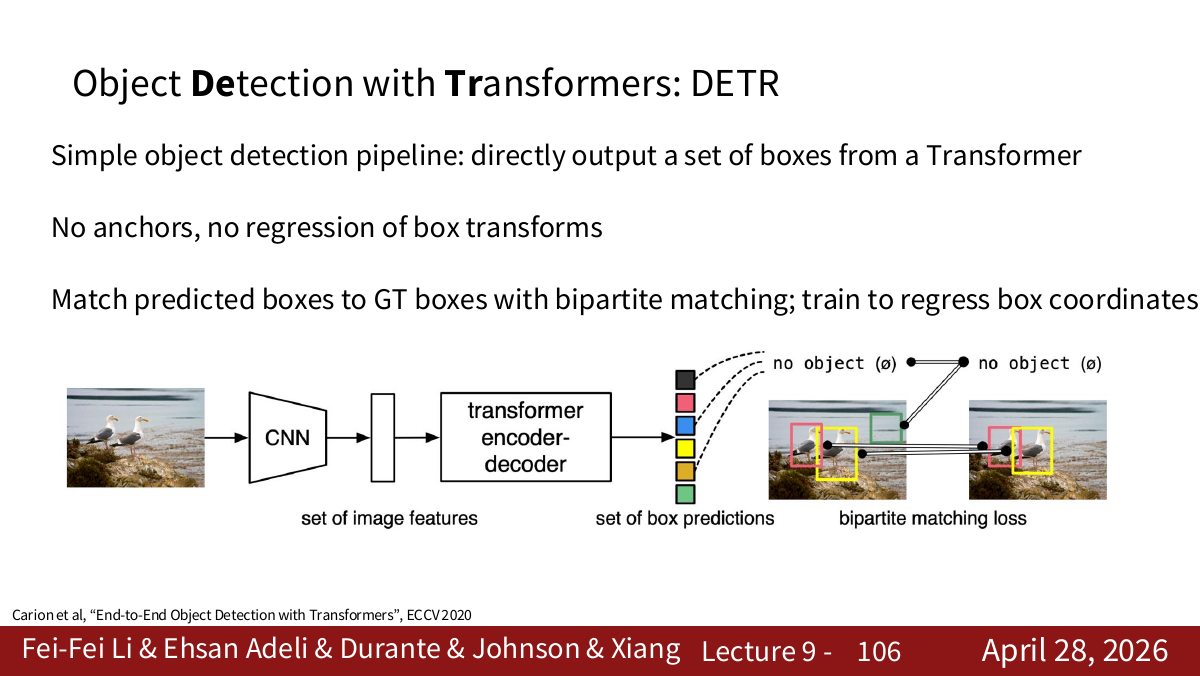
原始 DETR 训练慢、对小目标弱;多尺度特征和高效注意力是后续重点。
实例分割:Mask R-CNN
在 Faster R-CNN 的每个 RoI 后加 mask head,预测 掩码;仅对真实类别通道计算二元交叉熵。RoIAlign 用双线性插值而非 RoI Pooling 的整数坐标量化,避免掩码边界错位。
可解释性
Saliency Map
类别分数 对输入像素的梯度绝对值表示局部敏感度:
它显示“改动哪里会影响分数”,不等同于严格因果解释。
CAM 与 Grad-CAM
CAM 适用于最后卷积层接 GAP 和线性分类器:
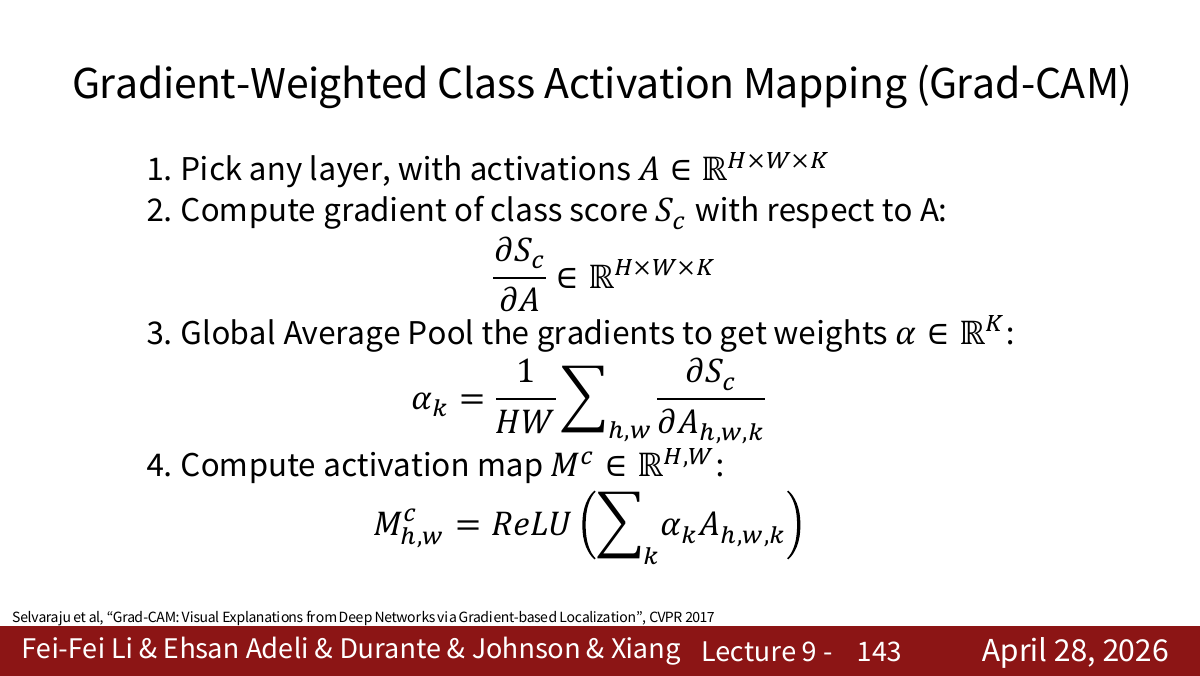
Grad-CAM 将任何层的梯度全局平均为通道权重:
要点
- 分割:语义 + 高分辨率,核心是编码器—解码器与 skip connection。
- 检测:两阶段精度导向,单阶段速度导向,DETR 将检测设为集合预测。
- 实例分割:检测框内做 mask,RoIAlign 保证像素对齐。
- 解释图用于诊断模型,不应单独作为模型可靠性的证据。