


Lec3: 正则化与优化
理解数据损失与正则化,比较梯度下降、SGD、优化器和学习率调度。
课程导航与课程讲次
课程讲次
文章目录
完整损失函数
- data loss:预测匹配训练数据。
- 正则化:阻止模型在训练数据上拟合得太好(含噪声),即避免过拟合,对应更简单的模型(Occam’s Razor)。
- :正则化强度,超参数。
正则化
常见形式:
更复杂:Dropout、Batch Normalization、Stochastic depth 等。
作用:表达对权重的偏好 / 让模型更简单以利泛化 / 为损失增加曲率改善优化。
L1 与 L2 的偏好(,,,二者得分相同):
- L2 偏好 ,倾向把权重 spread out 到所有维度。
- L1 倾向稀疏,把权重集中到少数维度。
优化
目标:找最小化 的 。
- 随机搜索:坏主意,CIFAR-10 上仅约 15.5% 准确率。
- 跟随斜率:负梯度方向是下降最快方向。
梯度计算:
- 数值梯度:有限差分 ,近似、慢、易写。
- 解析梯度:用微积分求闭式,精确、快、易错。
- 实践:用解析梯度,用数值梯度做 gradient check。
梯度下降与 SGD
# Gradient Descentweights += - step_size * weights_gradSGD:每步用 minibatch(32 / 64 / 128 / 256)近似全量梯度。
SGD 的问题
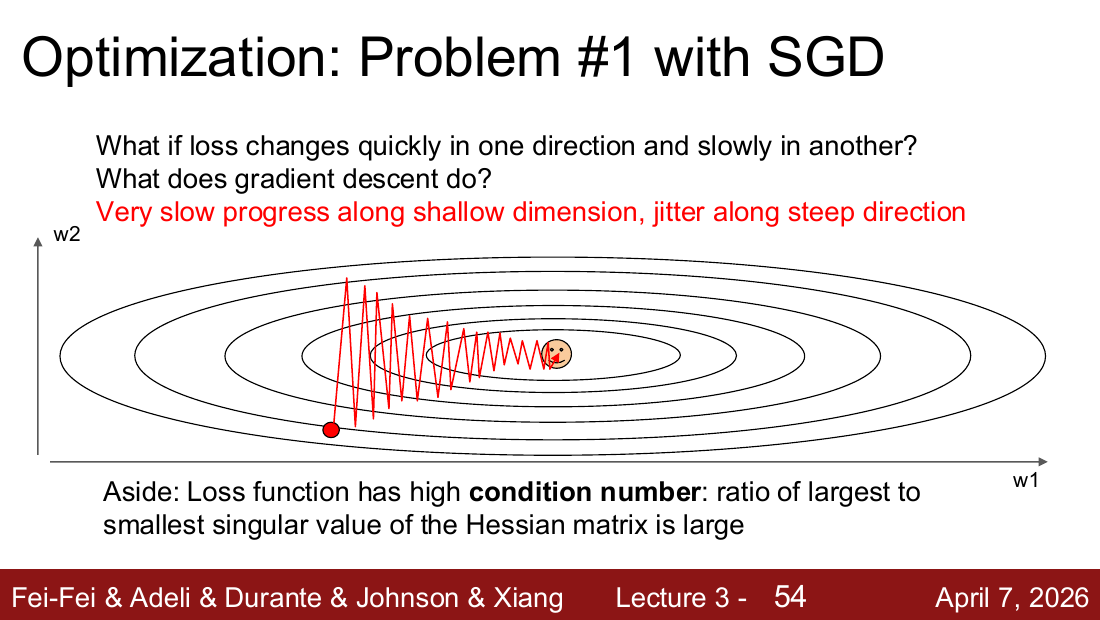
- 病态条件:某方向陡、某方向缓时来回震荡(zigzag),对应 Hessian 条件数大。
- 局部极小 / 鞍点:梯度为零卡住;高维中鞍点更常见。
- 梯度噪声:minibatch 梯度是带噪声的估计。
改进的优化器
SGD + Momentum:累积速度(历史梯度滑动平均),冲过鞍点、抑制震荡。
Nesterov:先沿速度前瞻一步再算梯度,更具前瞻性。
AdaGrad:累积梯度平方,按维度缩放步长(陡向抑制、缓向加速),但步长单调衰减至零。
RMSProp(Leaky AdaGrad):累积改为带衰减的滑动平均,避免步长衰减到零。
grad_squared = decay_rate * grad_squared + (1 - decay_rate) * dx * dxx -= learning_rate * dx / (np.sqrt(grad_squared) + 1e-7)Adam = RMSProp + Momentum,含偏差修正(一阶、二阶矩从零初始化会被低估)。
first_moment = beta1 * first_moment + (1 - beta1) * dx # 动量second_moment = beta2 * second_moment + (1 - beta2) * dx * dx # RMSPropfirst_unbias = first_moment / (1 - beta1 ** t) # 偏差修正second_unbias = second_moment / (1 - beta2 ** t)x -= learning_rate * first_unbias / (np.sqrt(second_unbias) + 1e-7)默认起点:,,lr 或 。
AdamW:解耦权重衰减,把正则化放到矩计算之后单独作用于参数,比把 L2 混入梯度效果更好。
学习率调度
学习率是上述所有优化器共有的关键超参数。
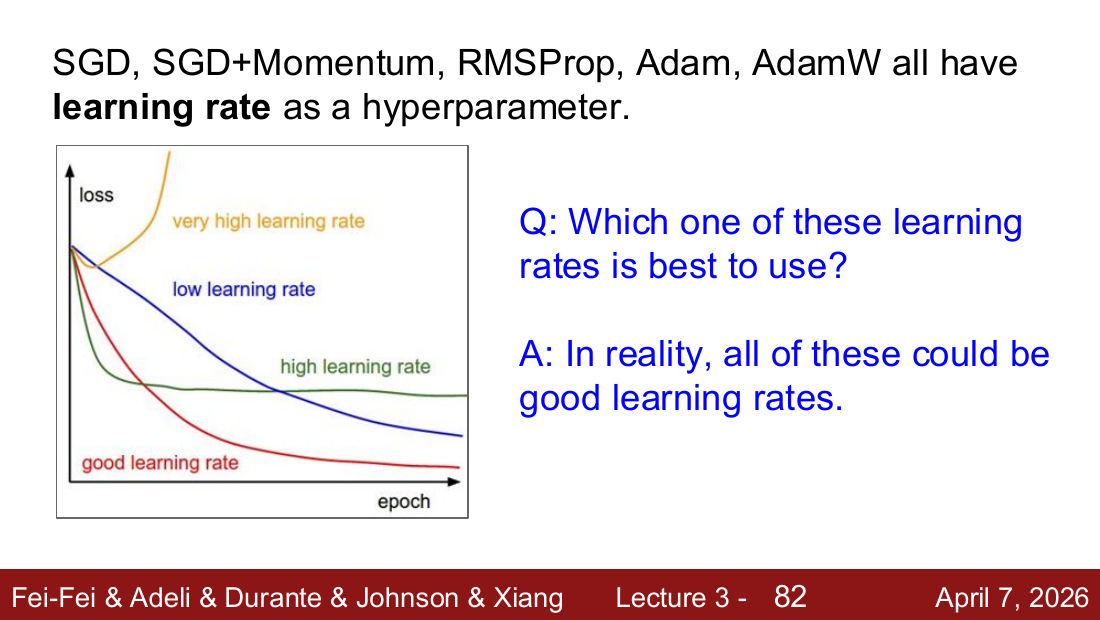
衰减策略( 初始、 第 epoch、 总 epoch):
Linear Warmup:初期 lr 从 0 线性升至目标值,防止损失爆炸;批量放大 倍,lr 也约放大 倍。
一阶 vs 二阶优化
二阶:用 Hessian 作二次近似,牛顿更新
深度学习中不可行:Hessian 有 元素,求逆 , 达千万级。
L-BFGS:全批量确定性设定下好用,minibatch 随机设定下效果差。
实践建议
- Adam(W):多数情况好的默认,常数学习率也常能用。
- SGD + Momentum:可能更优但需更多调 lr 与 schedule。
- 可全批量时可试 L-BFGS。
展望:神经网络
线性 无法分开某些数据。两层网络
通过非线性特征变换使数据可分。
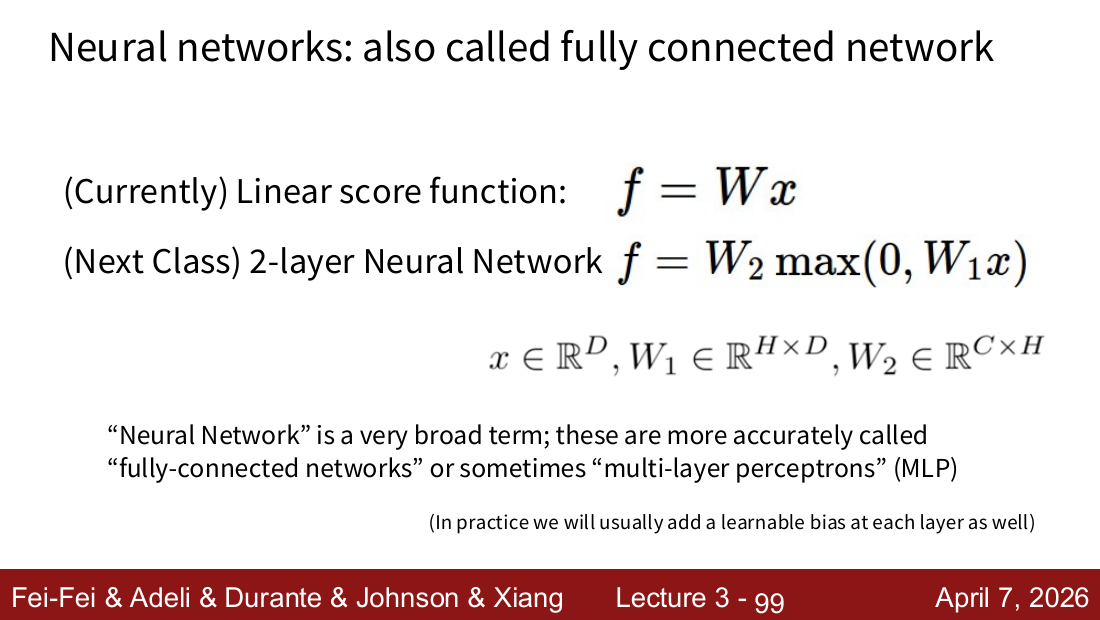
也称全连接网络 / MLP。下一讲:神经网络与反向传播。