


Lec7: 循环神经网络
序列建模、RNN 状态与时间反向传播,理解梯度流和 LSTM。
课程导航与课程讲次
课程讲次
文章目录
序列建模(变长输入/输出),Transformer 之前的序列建模主力,也是现代状态空间模型的前身。
序列范式
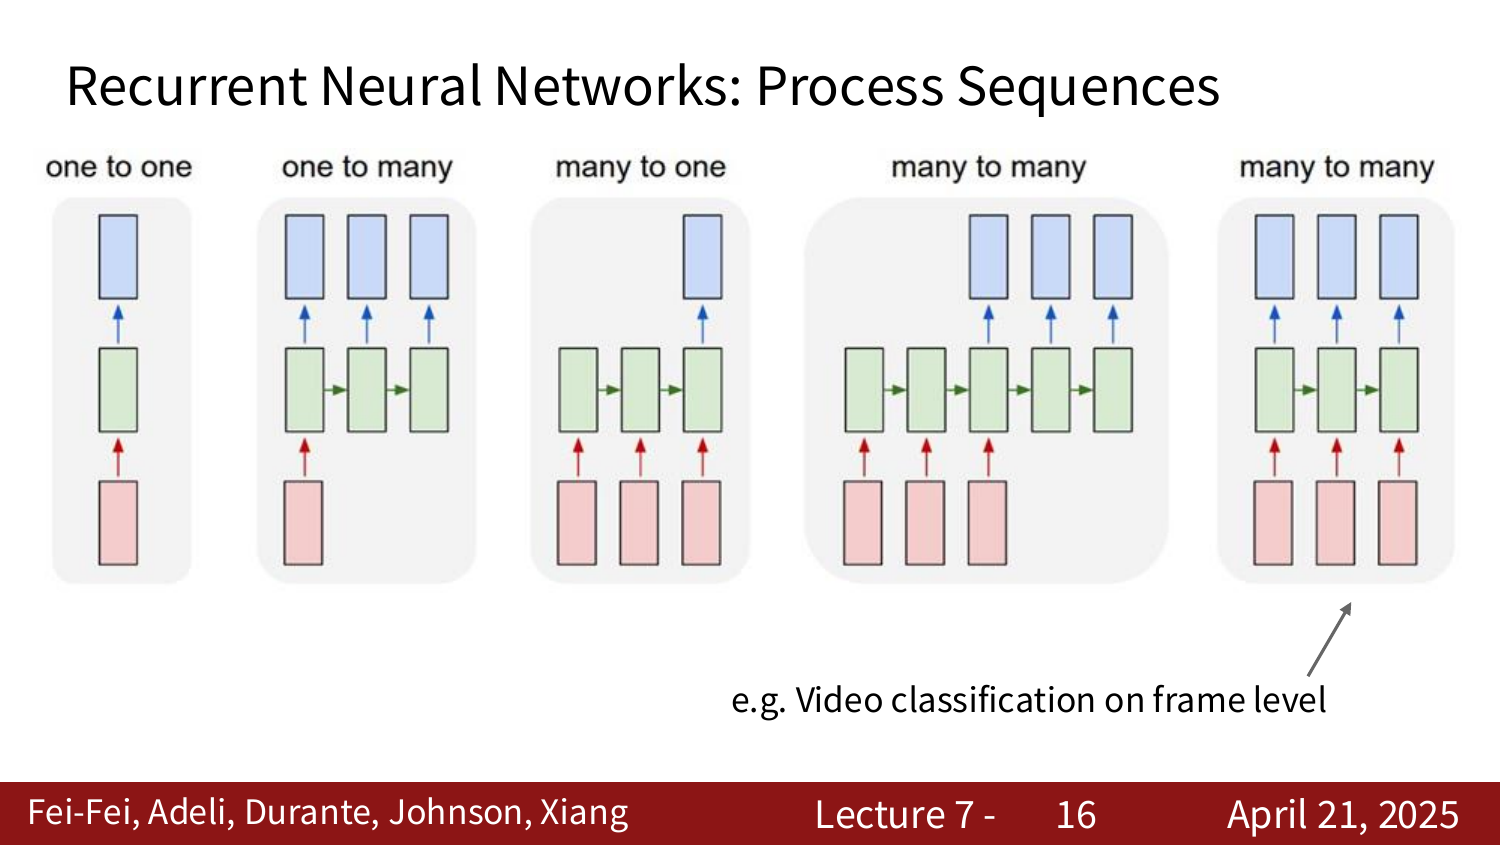
同一套循环结构覆盖多种输入输出组合:
- one to one:普通前馈网络(图像分类)。
- one to many:图像描述(图像 → 词序列)。
- many to one:动作识别(视频帧 → 类别)。
- many to many(异步):机器翻译。
- many to many(同步):逐帧视频分类。
核心:内部状态
维护一个随序列更新的隐藏状态:
关键:每个时间步用同一个 、同一组参数 (参数共享),故模型大小与序列长度无关。
Vanilla RNN
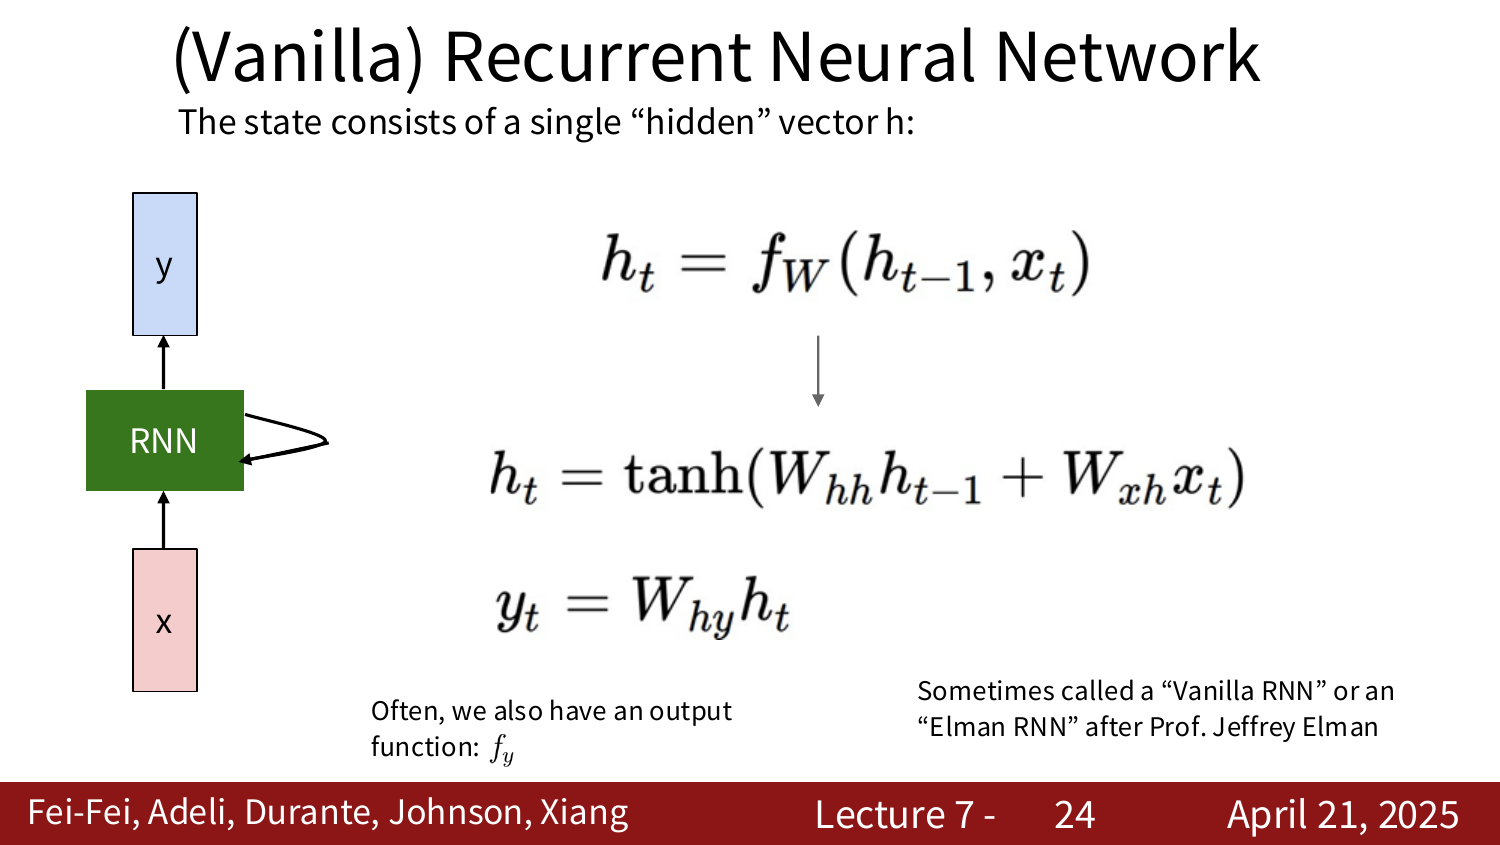
映射输入、 映射旧状态、 映射输出,三者跨时间步共享。
训练:时间反向传播
每步算 ,总损失 。BPTT:前向走完整序列算损失,再反向走完整序列算梯度。
截断 BPTT:序列切块,隐藏状态一直前传(保留长期上下文),但梯度只在块内回传,使长序列训练可行。
字符级语言模型
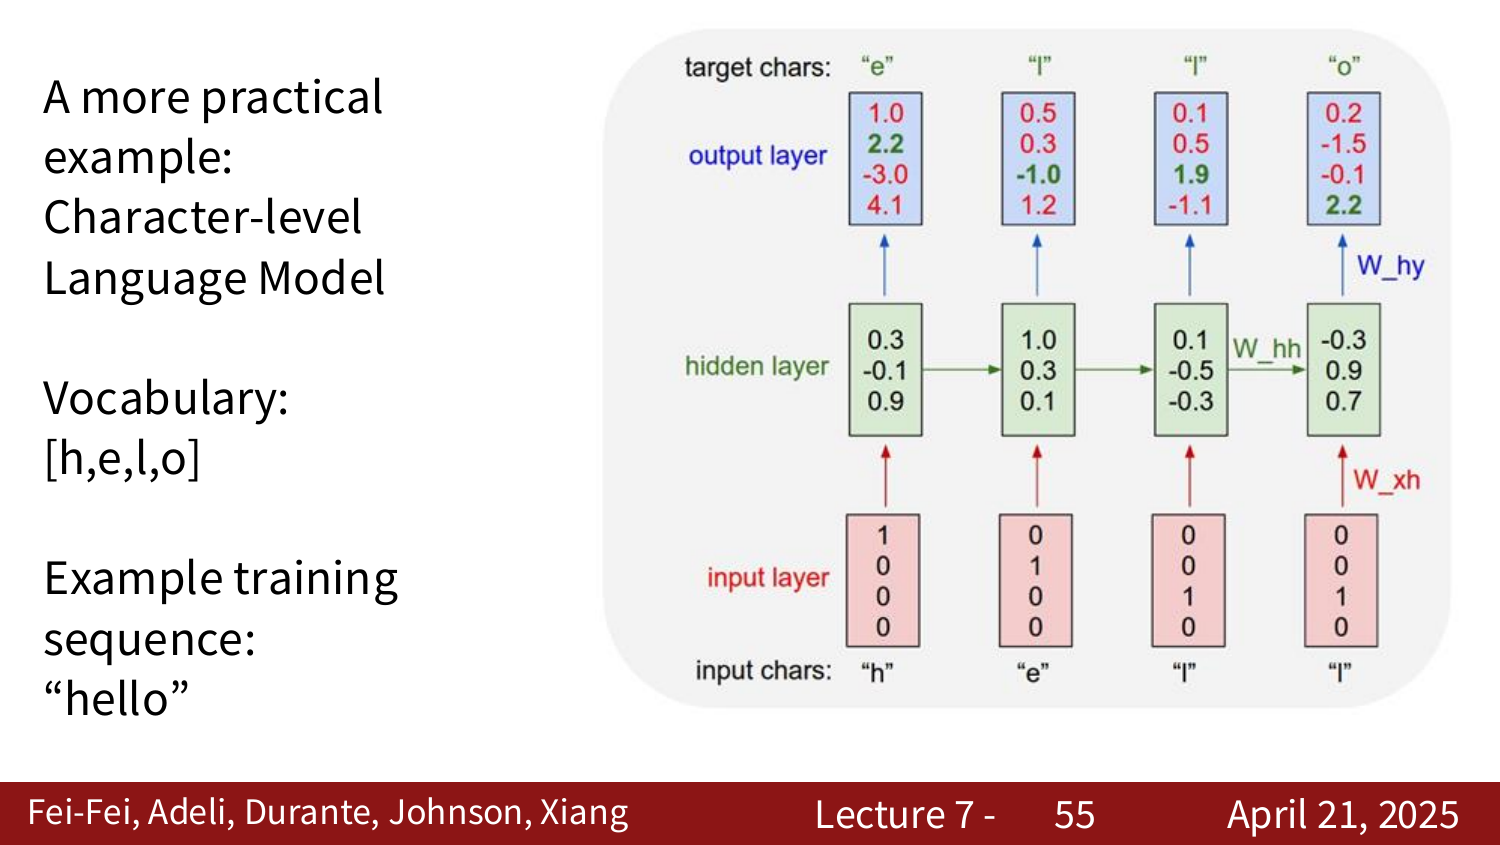
“hello” 例子:每步预测下一个字符,one-hot 输入,交叉熵 + BPTT 训练。
采样生成:逐字符按概率采样,并把采到的字符反馈为下一步输入。one-hot 乘权重等于取矩阵一列,故常单独设嵌入层(embedding layer)。
同一字符级 RNN 能生成文本、LaTeX、Linux C 代码;隐藏单元自发涌现可解释性(引号检测、行长跟踪、if 语句、代码缩进深度等)。
图像描述
CNN(去掉分类层)提取图像特征 ,注入隐藏状态更新:
从 <START> 起逐词采样,直到 <END>。同类多模态扩展:VQA、Visual Dialog。
优缺点
优点:处理任意长度输入、参数共享、理论上可用很久以前的信息。
缺点:循环计算串行、慢;实践中长程依赖难以学习。
梯度流
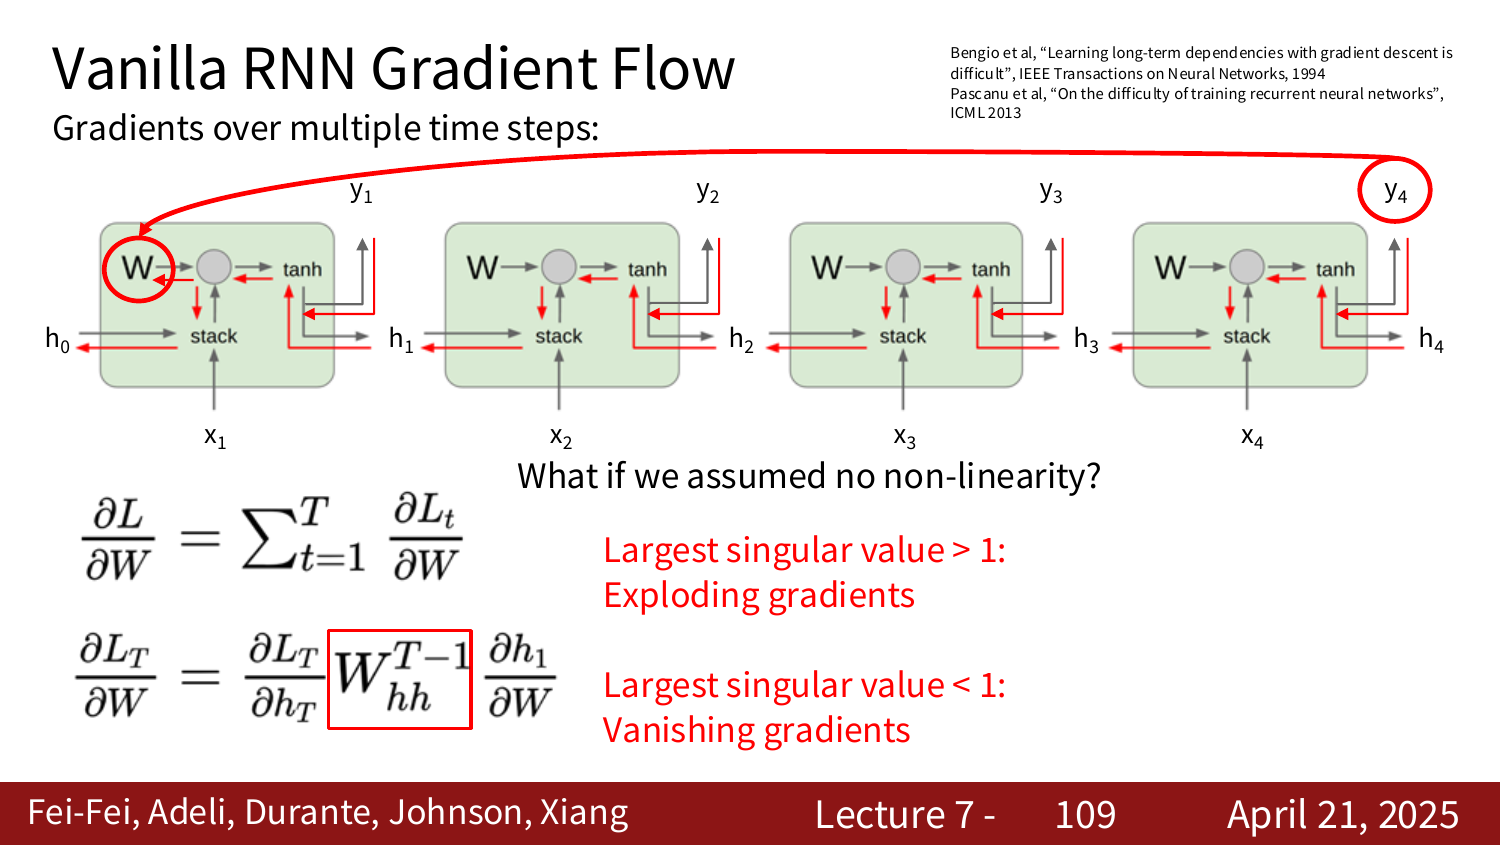
多步连乘 :
- 几乎总小于 ,连乘 → 梯度消失。
- 仅看 :最大奇异值 爆炸, 消失。
对策:爆炸用梯度裁剪(按范数缩放);消失需改变架构。
LSTM
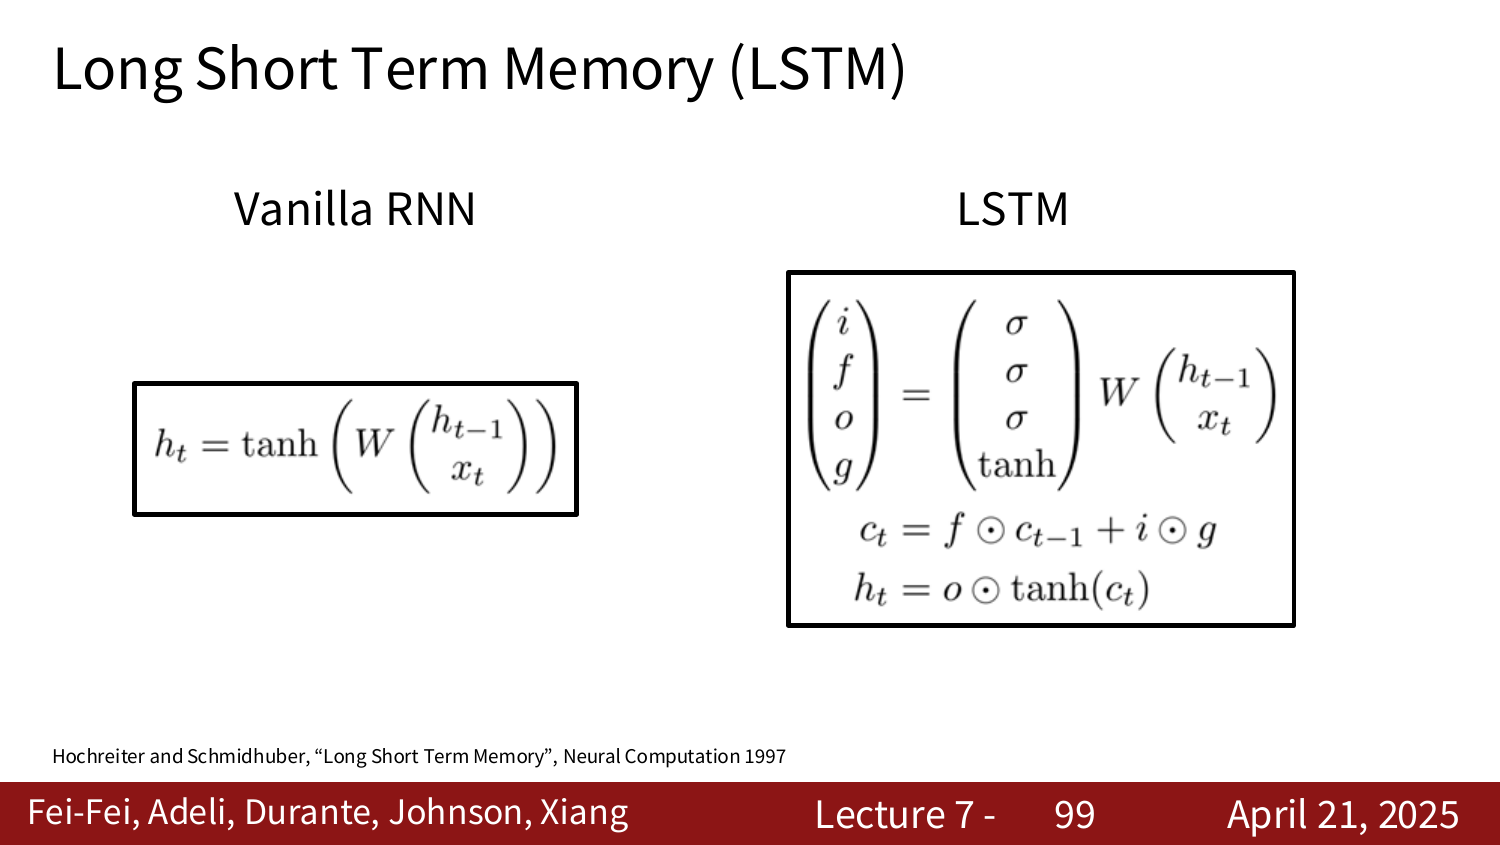
两个状态:隐藏状态 与细胞状态 。四个门:
门角色: 遗忘门(保留多少旧记忆)、 输入门(写入多少)、 候选内容、 输出门(暴露多少给 )。
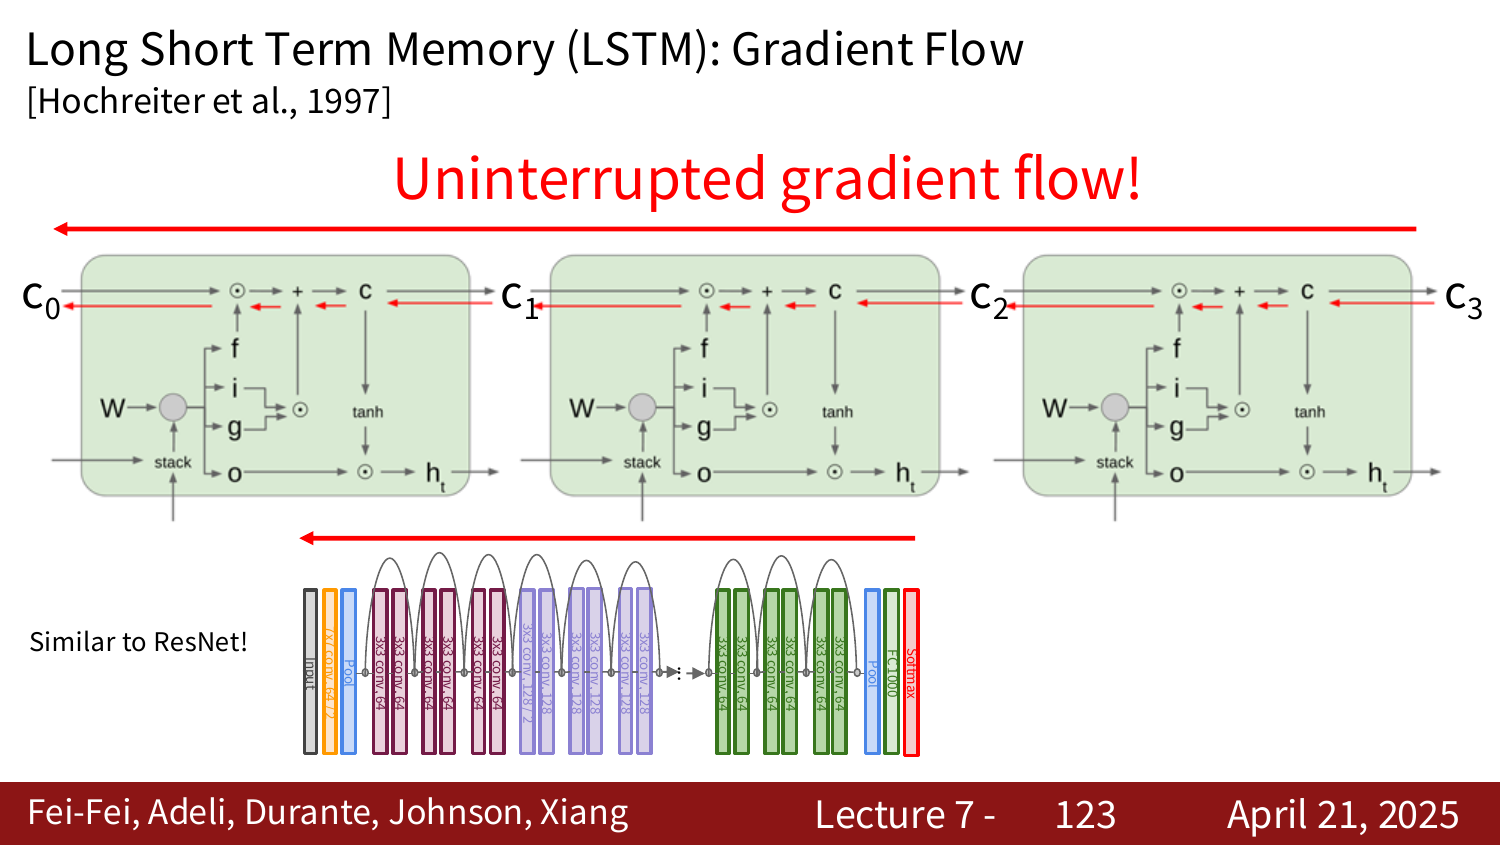
梯度沿细胞状态回传时只逐元素乘遗忘门 ,不再反复乘 ,形成近乎不被打断的梯度高速公路(类比 ResNet 残差连接)。 时信息无限保留。不保证完全无梯度消失/爆炸,但更易学长程依赖。
现代 RNN
状态空间模型(S4、RWKV、Mamba)延续 RNN 的状态思想,优势:上下文长度无限制、计算随序列长度线性增长(Transformer 为平方)。下一讲:注意力与 Transformer。