


Lec16: 视觉、语言与基础模型
从 CLIP 的对比学习与零样本分类,到 LLaVA、Flamingo 和视觉语言模型链。
课程导航与课程讲次
课程讲次
文章目录
基础模型先在大规模多样数据上预训练,再以微调、少样本或零样本服务多个任务。关键是通用和可迁移,而非单纯参数大。
CLIP
图像 encoder 和文本 encoder 将配对图文映射到同一归一化嵌入空间:
训练以图到文和文到图的对称 InfoNCE 拉高正确配对对角线、压低 batch 内错误配对:
训练信号是大规模 alt-text 图文对;它是嘈杂语言监督,而非“无标签”。
零样本分类
为每类写 prompt,如 “a photo of a {class}”,文本 embedding 当作类别原型;图像与原型点积最大者为预测类别。多模板平均的 prompt ensemble 通常更稳健。
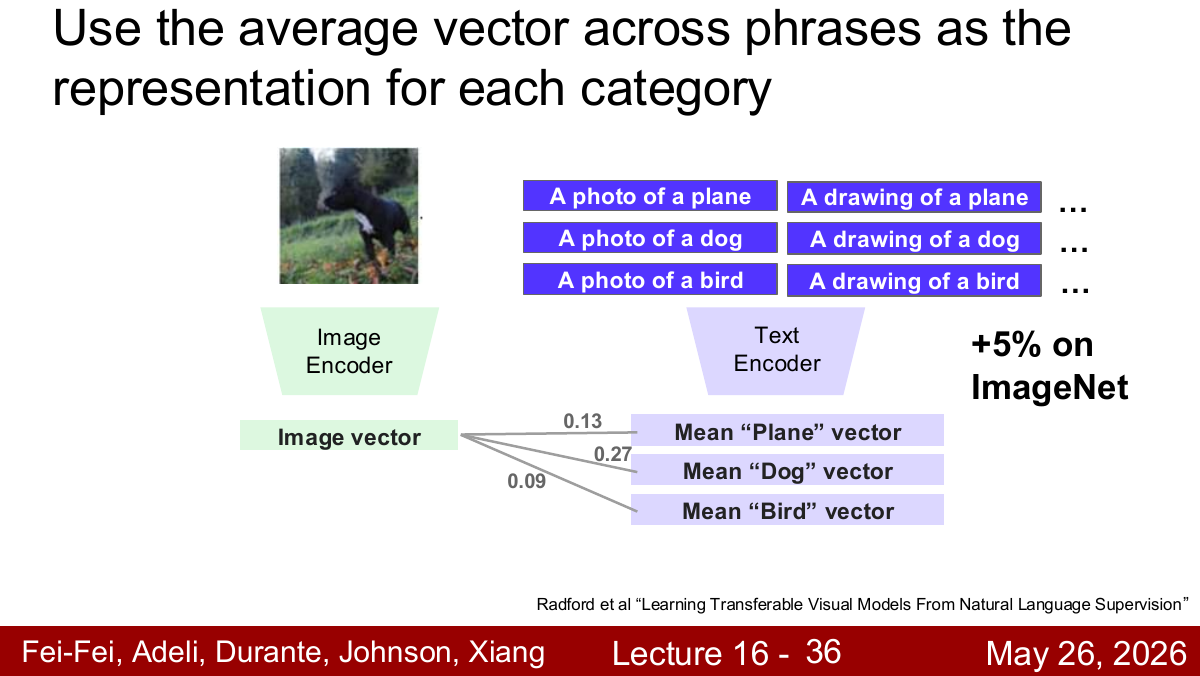
优点:点积检索极快、开放词汇、零样本迁移。限制:依赖大 batch 负样本,组合关系/主客体顺序差;图像级 caption 缺定位、计数等细粒度监督。hard negative、区域描述和更有意的数据能缓解,但要避免把语义相同的 hard positive 当负样本。
SigLIP 以 sigmoid 替代 batch 全局 softmax,节省 batch 相似度矩阵内存;CoCa 在 CLIP 对比目标上加 caption generation。
LLaVA
- CLIP ViT 提取图像 patch token,常取倒数第二层。
- 线性/MLP projector 映射到 LLM 词嵌入维。
- 将视觉 token 与文本 token 一起送入自回归 LLM。
- 先训练 projector 对齐,再用图文指令数据微调。
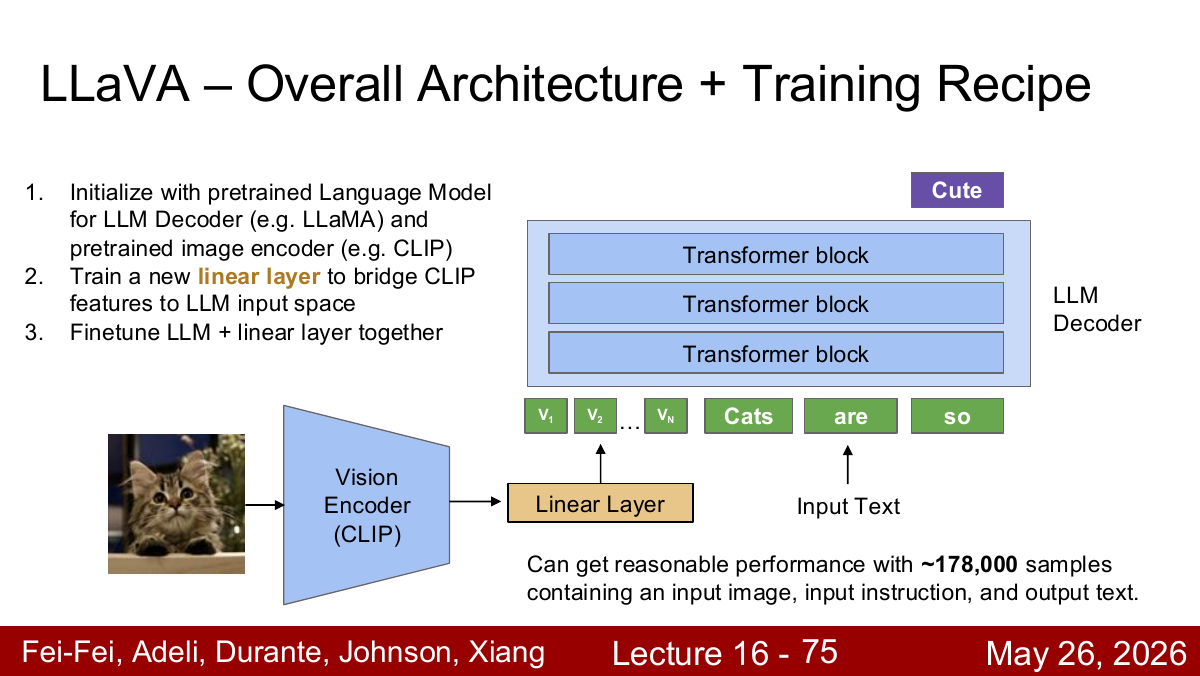
训练只对回答文本做 next-token loss。优点是复用预训练视觉与语言先验;限制是视觉分辨率、视觉 token 预算和训练数据的细粒度监督。
Flamingo 与模型链
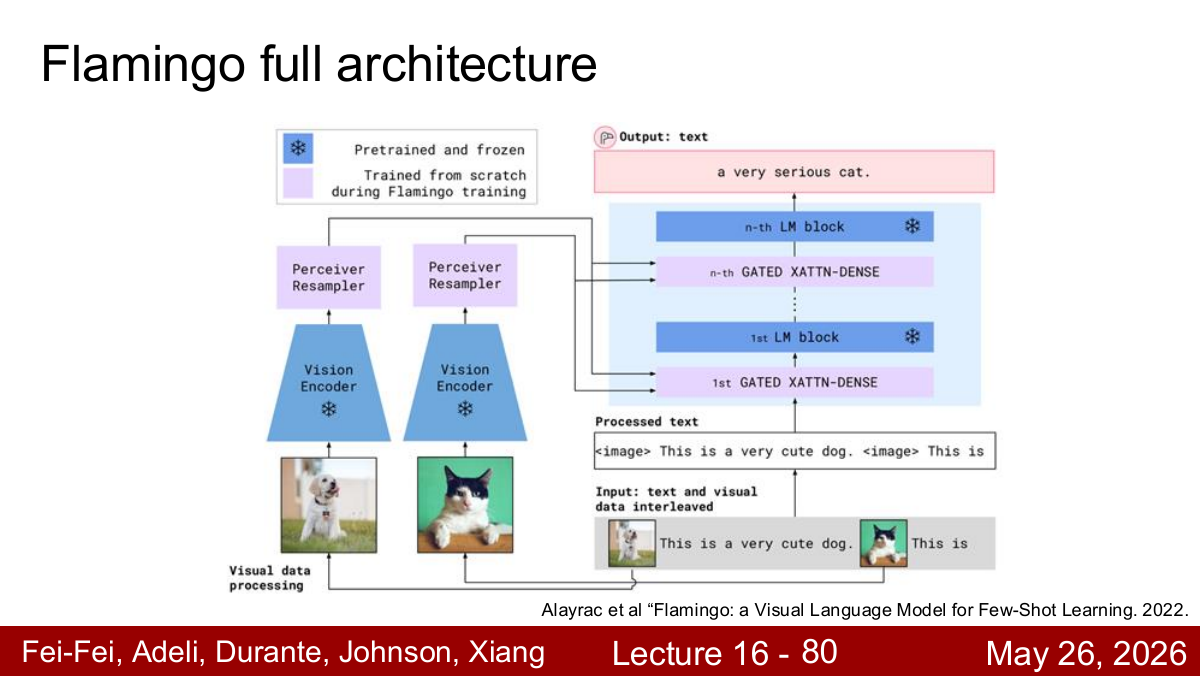
Flamingo 先以 Perceiver Resampler 把可变数量视觉 token 压为固定 latent,再在 LLM 中插入 gated cross-attention 读取视觉信息;多图文本按语言模型序列交织,可做 in-context few-shot。
CuPL 用 LLM 为类别生成视觉描述,再交给 CLIP 零样本分类。VisProg 用 LLM 把复杂视觉问题编排成检测、分割、VQA 等模型调用程序;组合性强,但中间错误会累积。
“open weight”仅表示权重可下载;完整开放还需要数据、代码、训练细节和评测。多模态模型质量不仅取决于数据数量,也取决于标注密度、意图与覆盖范围。