GAN#
生成器 G(z) 把简单先验 z∼p(z) 变为假样本;判别器 D(x) 预测真实概率:
GminDmax Ex∼pdatalogD(x)+Ez∼p(z)log(1−D(G(z))).理论最优判别器:
DG∗(x)=pdata(x)+pG(x)pdata(x).原 minimax 目标在早期 D(G(z))≈0 时生成器梯度饱和,常改用非饱和损失 LG=−EzlogD(G(z))。
优点:形式简单、图像锐利、latent 插值平滑。缺点:训练不稳定、mode collapse、无可靠单一 loss curve、难扩展。
Rectified Flow#
从数据 x、噪声 z 和 t∼U[0,1] 构造:
xt=(1−t)x+tz,v=z−x.训练速度预测器:
L=E∥fθ(xt,t)−(z−x)∥22.采样从噪声出发,按反向 Euler 步更新:
xt−1/T=xt−T1fθ(xt,t).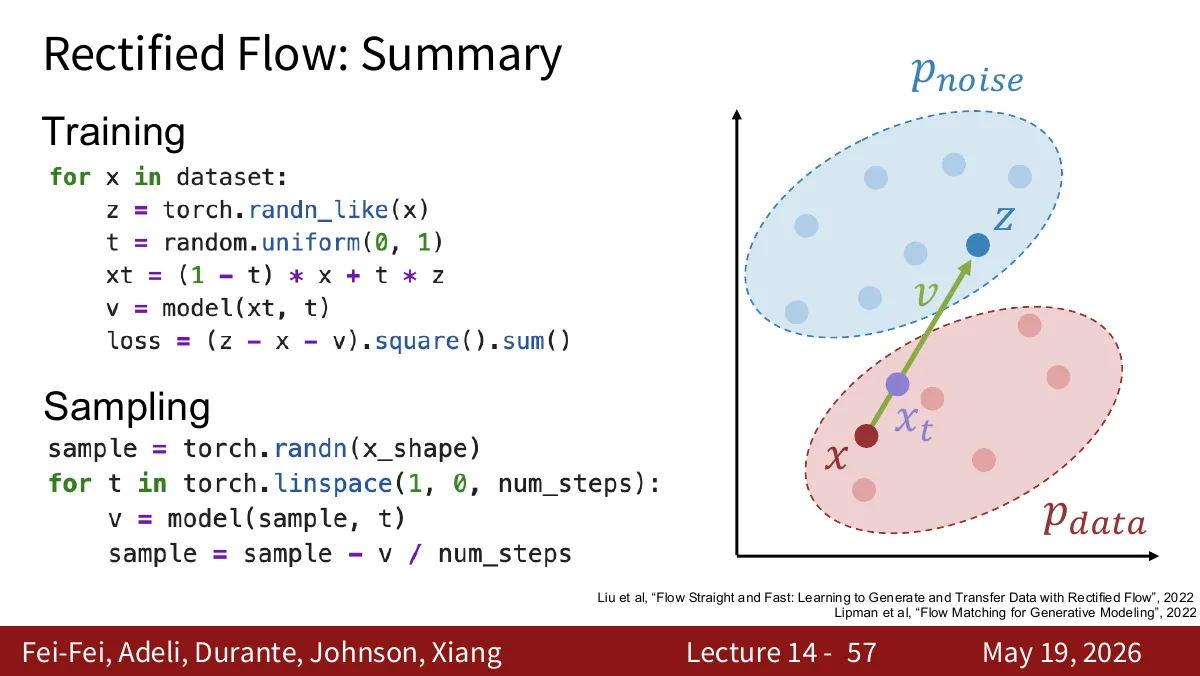
训练是稳定的回归;采样需多步网络前向,较慢。
条件生成与 CFG#
训练时随机丢弃条件 y,获得
v∅=fθ(xt,∅,t),vy=fθ(xt,y,t).采样使用
vcfg=(1+w)vy−wv∅.w 增大提示词遵从性,也可能降低多样性;CFG 需要两次前向,成本约翻倍。
Latent Diffusion 与 DiT#
LDM 先将图像压缩为 H/D×W/D×C latent,在 latent 中扩散,最后 VAE decoder 还原图像。压缩器常为小 KL 权重 VAE,并加 GAN 损失改善清晰度。
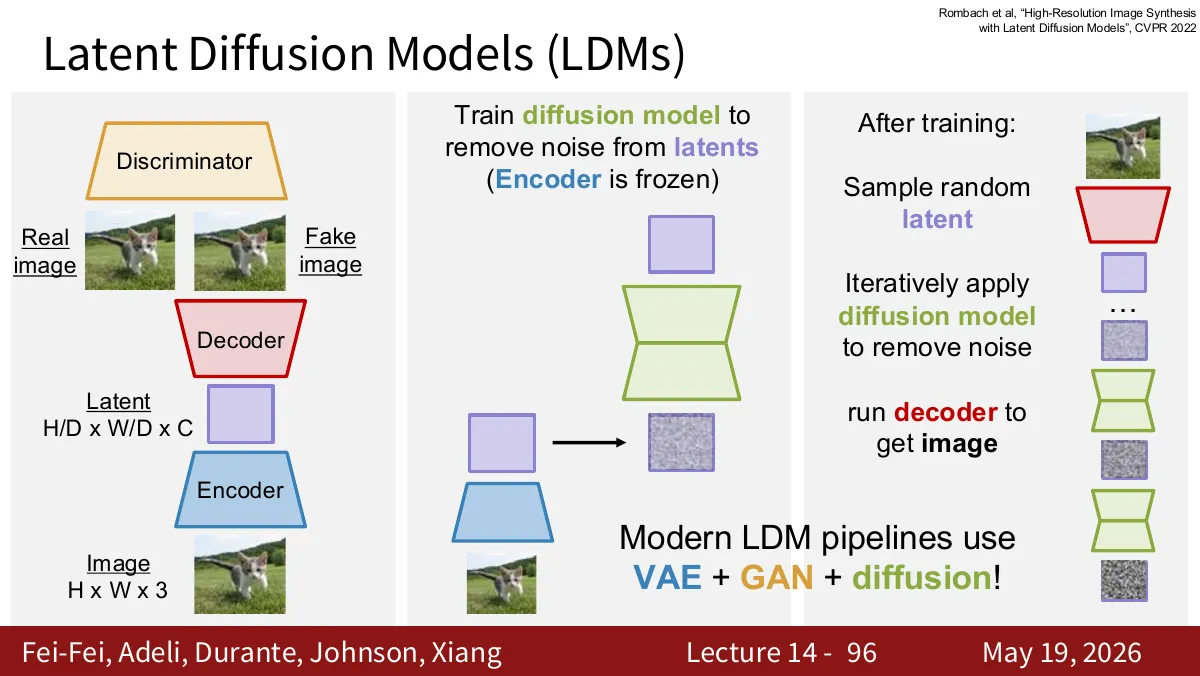
DiT 以 Transformer 做去噪;时间步常经 scale/shift 调制归一化,文本/图像条件常经 cross-attention 或 joint attention 注入。文本到视频只是在 latent 上增加时间维,但 token 数、时序一致性和计算成本都更难。
扩散还可预测 x、噪声 ϵ 或 v;本质是学习从噪声分布回到数据分布的方向。蒸馏可减少采样步数。