从线性到神经网络#
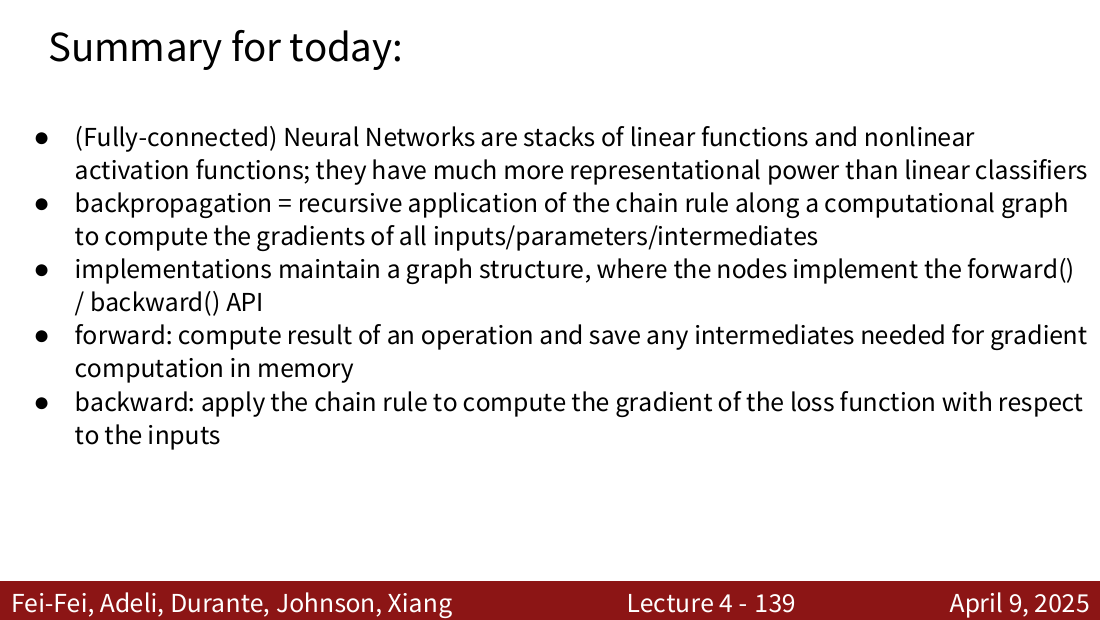
线性分类器 f=Wx 只能用超平面切分、每类只学一个模板,无法处理非线性可分数据。
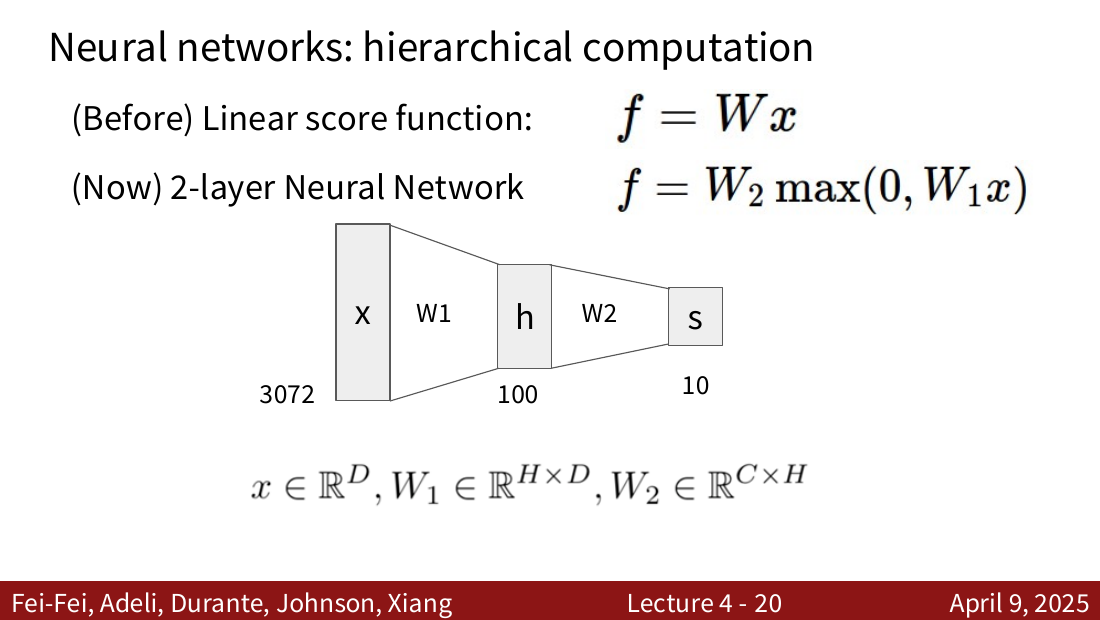
两层神经网络:
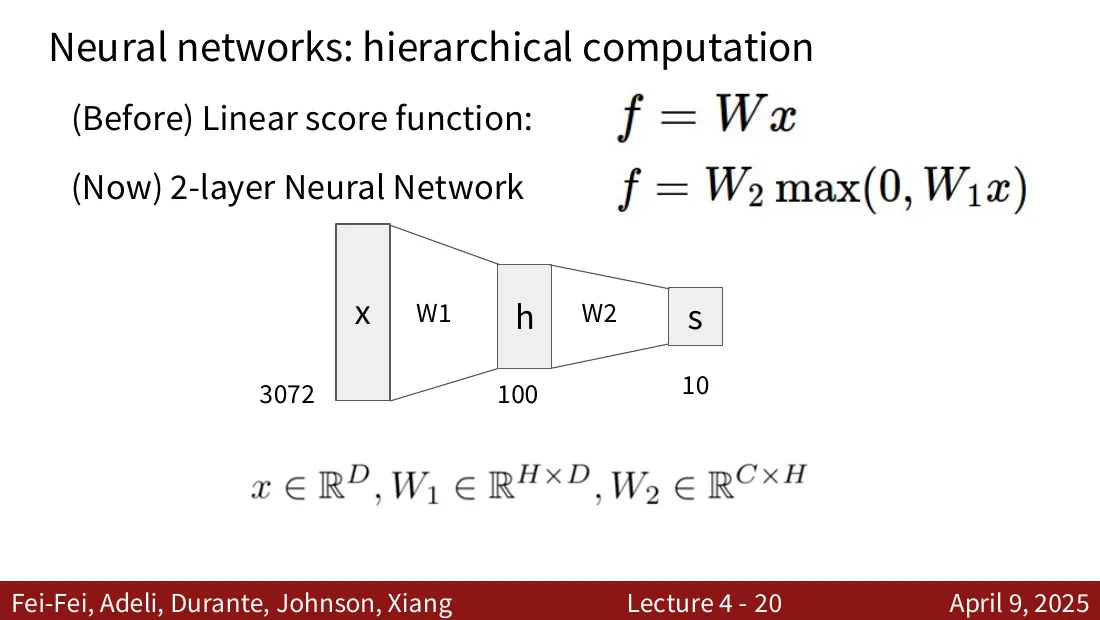
f=W2max(0,W1x),x∈RD, W1∈RH×D, W2∈RC×H.分层计算 x→h=max(0,W1x)→s,相当于学习并共享上百个模板。
三层:f=W3max(0,W2max(0,W1x))。每层实际还加可学习偏置。
为什么需要非线性#
去掉激活函数:
f=W2W1x=W3x,又退化为线性分类器。非线性激活是深度有意义的前提,作用是做特征变换使数据线性可分。
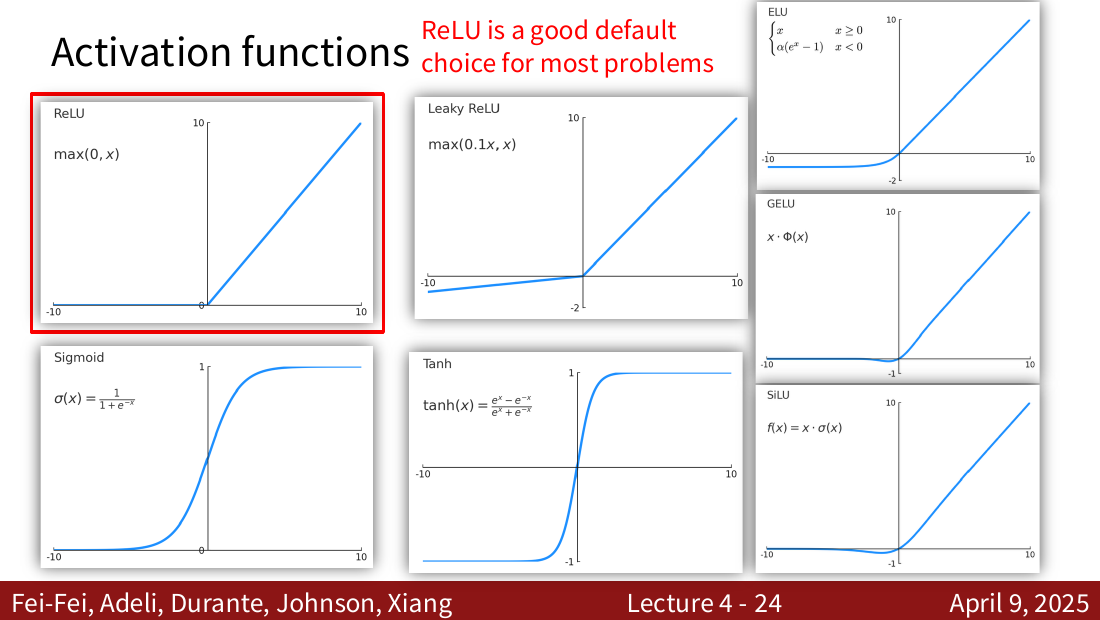
激活函数#
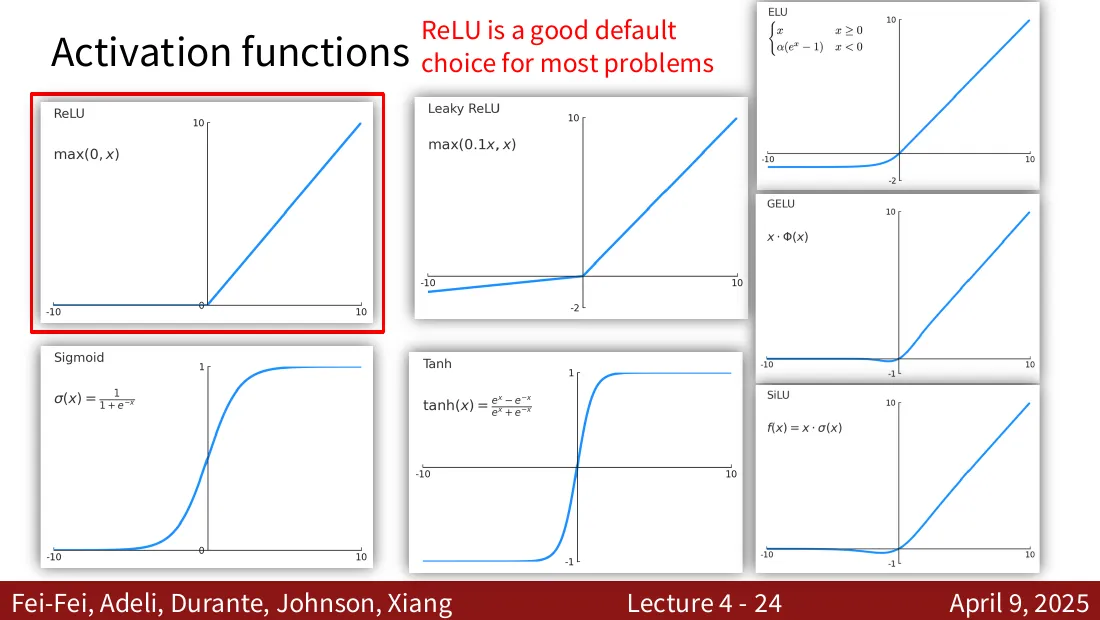
- ReLU max(0,x):默认首选
- Leaky ReLU max(0.1x,x)
- Sigmoid σ(x)=1/(1+e−x)
- Tanh、ELU、GELU、SiLU
结构与术语#
输入层 / 隐藏层 / 输出层,层间全连接。“N-layer” 只数带权重的层:2-layer = 1-hidden-layer。也叫全连接网络 / MLP。
容量由隐藏单元数决定。不要用网络规模做正则化,应保持大网络并调正则化强度 λ。
反向传播#
目标:对复杂损失计算 ∂L/∂W。纸上手推不可行(繁琐、不模块化、复杂模型做不了)。
解法:计算图 + 反向传播,即在图上递归应用链式法则。
节点抽象#
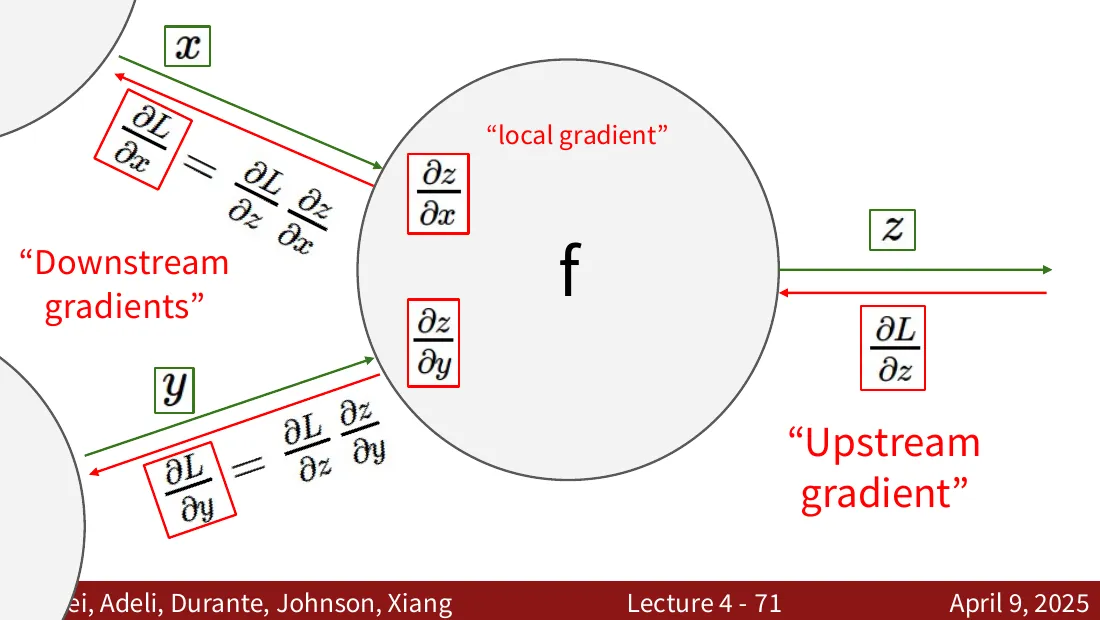
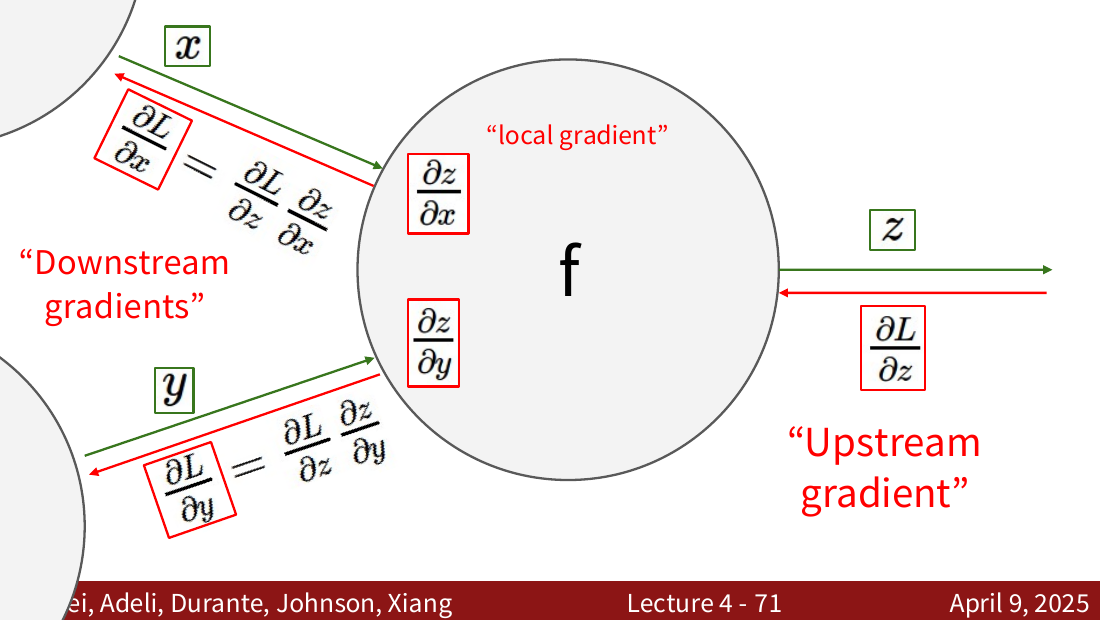
每个节点:
- 局部梯度 ∂z/∂x(前向时算)
- 上游梯度 ∂L/∂z(下游传来)
- 下游梯度 = 上游 × 局部:
∂x∂L=∂z∂L∂x∂z.
简单例子#
f=(x+y)z,令 q=x+y,f=qz。反向:∂f/∂f=1→∂f/∂z=q, ∂f/∂q=z→∂f/∂x=∂f/∂y=z。
Sigmoid 门#
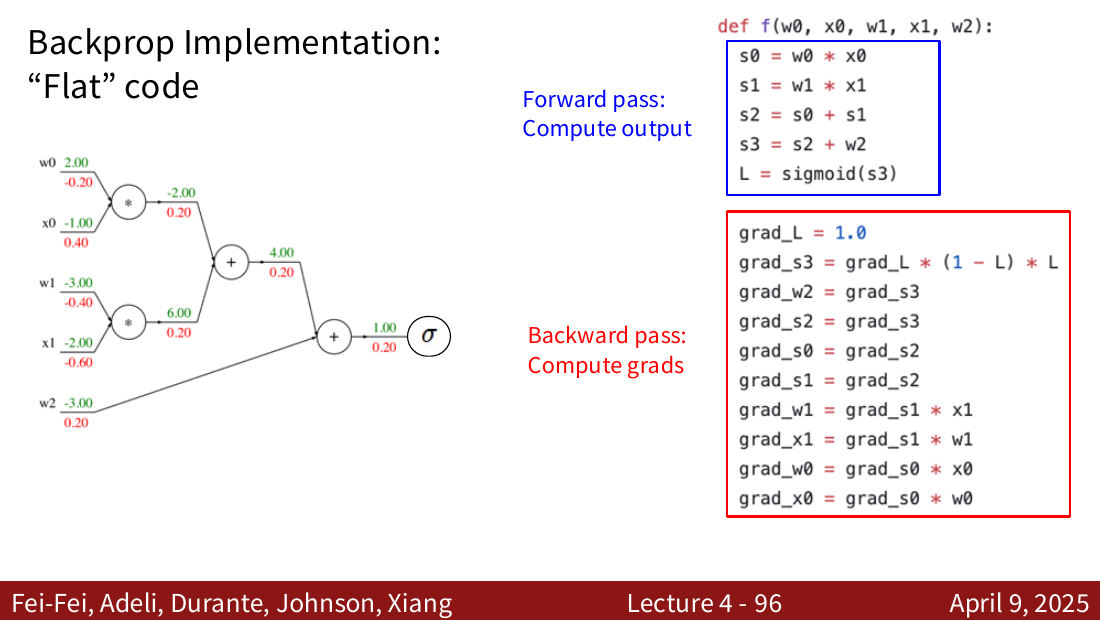
计算图划分不唯一,应让每个节点局部梯度好写。把多步打包成 sigmoid:
dxdσ(x)=(1−σ(x))σ(x).
梯度流模式#
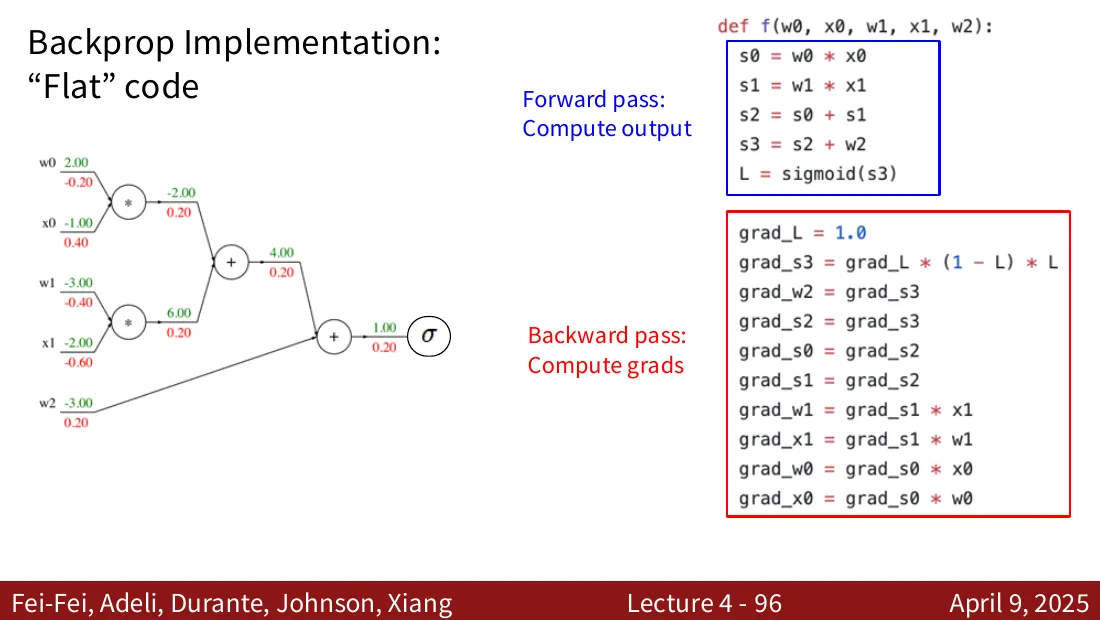
- 加法门:梯度分发器(原样分发)
- 乘法门:交换乘子(乘以另一输入)
- 复制门:梯度累加器(各分支相加)
- max 门:梯度路由器(只给最大的那个)
模块化实现#
每个算子实现 forward / backward:forward 算输出并缓存中间值,backward 用上游 × 局部得下游。
class Multiply(torch.autograd.Function):
ctx.save_for_backward(x, y)
def backward(ctx, grad_z):
return y * grad_z, x * grad_z
向量 / 矩阵形式#
导数三形态:标量对标量(导数)、向量对标量(梯度)、向量对向量(雅可比)。
链式法则为矩阵-向量乘法 ∂x∂L=∂x∂z∂z∂L。
关键事实:∂L/∂x 形状始终与 x 相同。
ReLU 雅可比对角且稀疏,输入为正处保留上游梯度、为负处置零;用隐式逐元素乘法,不显式构造雅可比(可达数百 GB)。
矩阵乘 y=xw 的梯度:
 ∂x∂L=(∂y∂L)wT,∂w∂L=xT(∂y∂L).
记忆技巧:唯一能让形状匹配的组合。
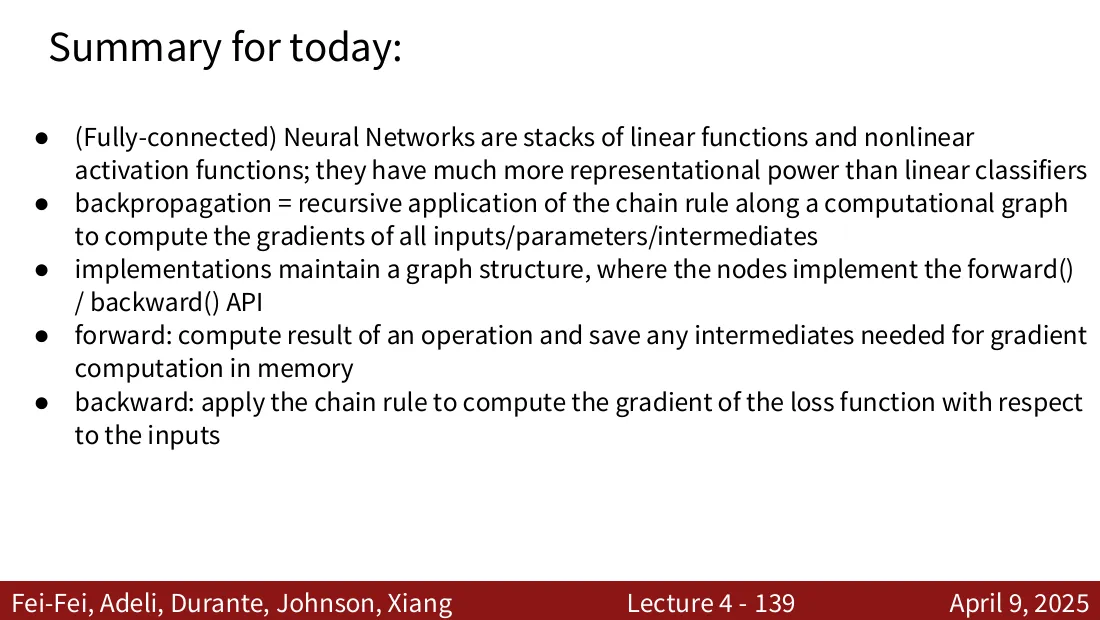
- 神经网络 = 线性 + 非线性堆叠,表达力强
- 反向传播 = 计算图上递归链式法则
- 节点实现 forward(算输出、存中间值)/ backward(上游 × 局部)
- 梯度形状与变量相同;雅可比隐式处理
下一讲:卷积神经网络(CNN)。