


Lec11: 大规模分布式训练
集合通信、数据并行、FSDP、激活检查点和多轴并行的计算与内存权衡。
课程导航与课程讲次
课程讲次
文章目录
Transformer 激活可看作 张量。大规模训练就是沿不同轴切分,并在内存、通信和计算之间权衡。
集合通信
- All-Reduce:所有卡得到 ;DDP 同步梯度。
- Reduce-Scatter:每卡得到全局归约的一块;FSDP 反向同步梯度。
- All-Gather:每卡收集所有分块;FSDP 前向临时恢复权重。
- All-to-All:重排张量的分片轴;Ulysses CP 使用。
GPU 内带宽远大于跨机带宽,通信应尽量局限在相邻设备组,并尽可能与计算重叠。
数据并行与 FSDP
有 卡、每卡 batch :
DP:每卡保存完整模型,处理不同数据,All-Reduce 平均梯度。它增大吞吐但模型必须装入单卡。
FSDP / ZeRO-3:参数、梯度、优化器状态按卡分片;某层计算前 All-Gather 权重,使用后释放;反向用 Reduce-Scatter 梯度。以更多通信换取近似 的模型状态内存。
HSDP:组内 FSDP、组间 DP,避免让参数聚合跨越整个大集群。
Activation Checkpointing
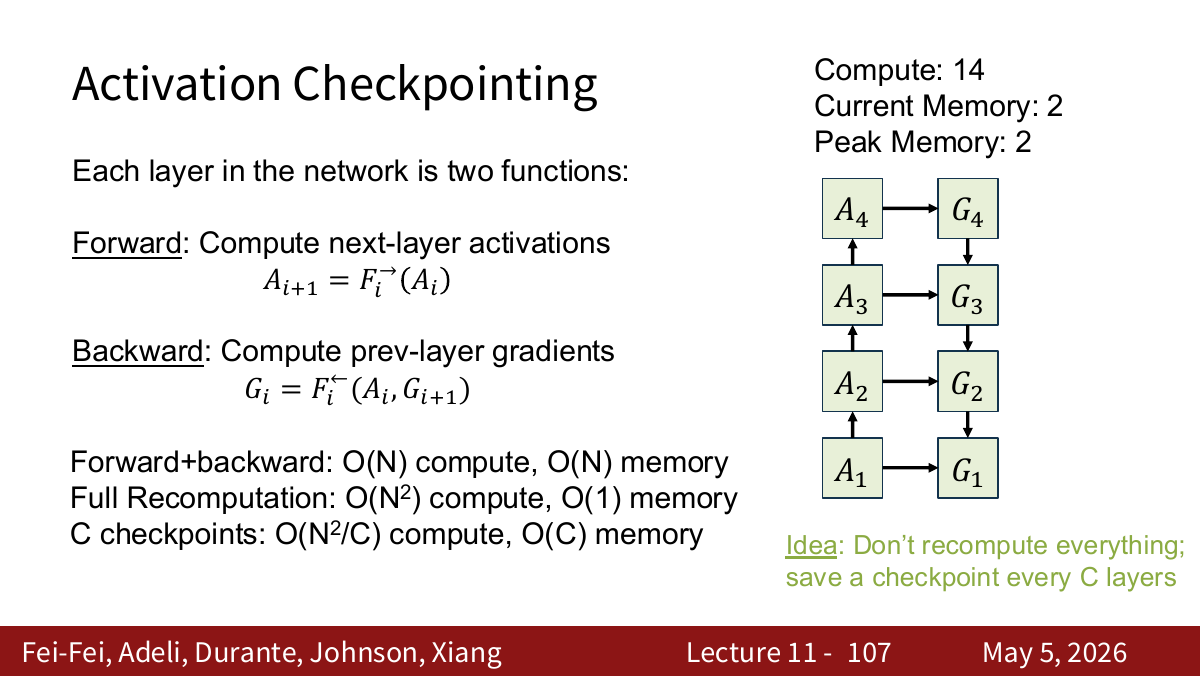
普通反向保存所有 层激活: 计算、 内存。全重算可降到 内存,却为 计算。每隔若干层保存 checkpoint,在相邻 checkpoint 内重算,是可用的折中。
四种并行
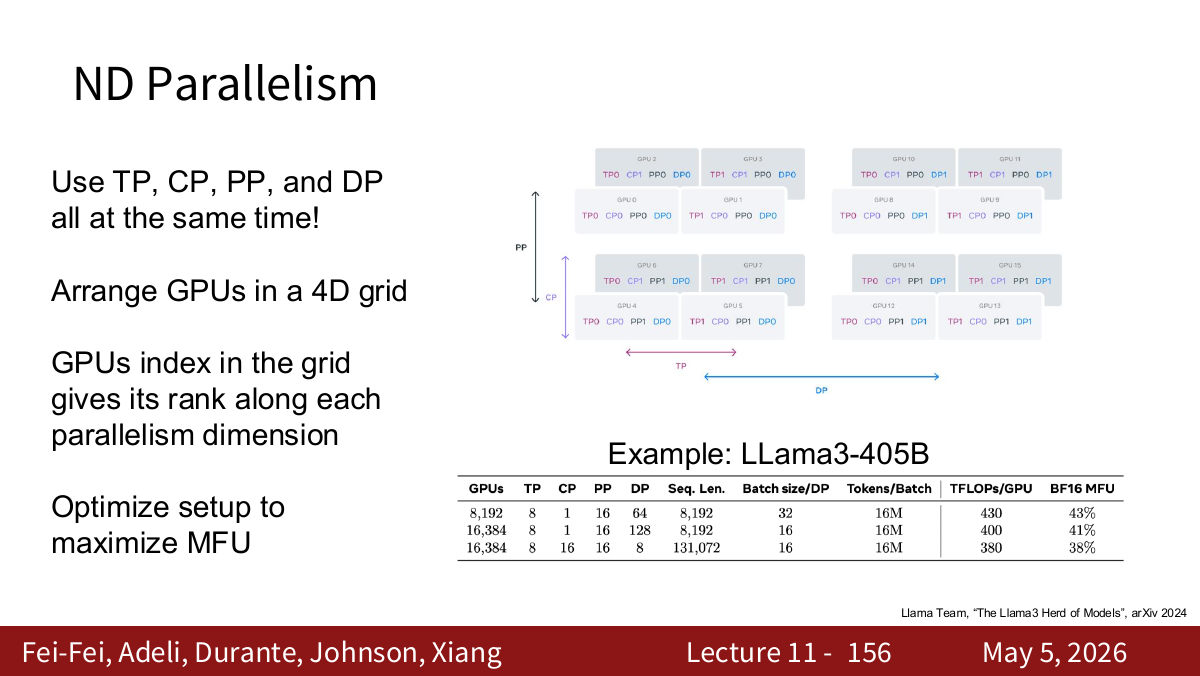
- DP:切 batch;同步完整模型副本的梯度。
- CP:切 sequence;MLP 可独立处理 token,attention 需跨卡组织 。Ulysses 经 All-to-All 改为按 attention head 分片;Ring Attention 以环传递 block。
- PP:切 layer;microbatch 填充 pipeline bubble,提升 GPU 利用率。
- TP:切 channel / 线性层矩阵。相邻层采用列并行接行并行,在中间避免通信,最后 All-Reduce。
MoE 还会用 EP 把专家分放不同 GPU。实际训练往往是 TP + CP + PP + DP 的多维组合。
MFU
MFU 衡量端到端迭代中真正用于模型矩阵乘的理论时间占比,包含通信、数据加载、重算后的实际开销。经验上 MFU 超过 30% 已较好,超过 40% 很优秀。